


当 Agent 开始「做梦」,以及如何建立起企业长期记忆
从 Anthropic 的四层 Agent 记忆与 dreaming 机制出发,看企业如何建立不随任何单个 Agent 消失的长期记忆。
浏览 4
巴克励步

记忆不是发生过的事的存档,是替还没发生的会话,提前备好它要用的那一部分。
11 月 6 日 Anthropic 发布《The components of agent memory》那天,我把 15 张图和五组实验从头看到尾。
倒不是因为又多了个「记忆功能」。做企业 SaaS 知识管理十五年,我大半时间都泡在企业内容管理和知识治理里:一份材料哪一版算数、谁能看、依据哪份原件、谁改过、什么时候到期、出了错能不能撤回。这两年 AI 起来,我的注意力很自然地挪到了提示词、上下文、记忆、知识这些词上——不是追新词,是发现老问题换了个地方又冒出来,而且这回是被模型自己撞上的。
所以这篇文章我读得敏感。它讲的是 Claude 怎么记东西,可我看到的几乎全是我熟的那套麻烦:写下来的判断会错,错的东西会被反复信任,文档堆得再多也未必有人找得到,整理这件事总得有人(或者有什么东西)在没人用的时候去做。Anthropic 给这套动作起了个很好听的名字,叫 dreaming——做梦。
一个 Agent 在空闲时重读自己的日志、纠正记错的事、把零散笔记连成一张可导航的 wiki、再把最要紧的几条提到每次会话都会加载的常驻上下文里。读到这里我停了一下:这不就是知识沉淀吗,只不过执行者从知识管理员换成了模型,节奏从季度变成了夜里。
而企业真正要回答的问题还要再难一层:一个 Agent 学会做梦之后,一个组织怎么建立起不会随任何单个 Agent 消失的长期记忆?
我最在意的,是顶上那两层
原文把记忆分成四层,从下往上是 transcripts(可搜索的事件日志)、memory notes(会话里写下的笔记)、memory representations(比如 wiki)、injected context(每次会话预加载的常驻上下文)。下面两层是原料,我更在意上面两层:一个随时在场,一个按需导航。
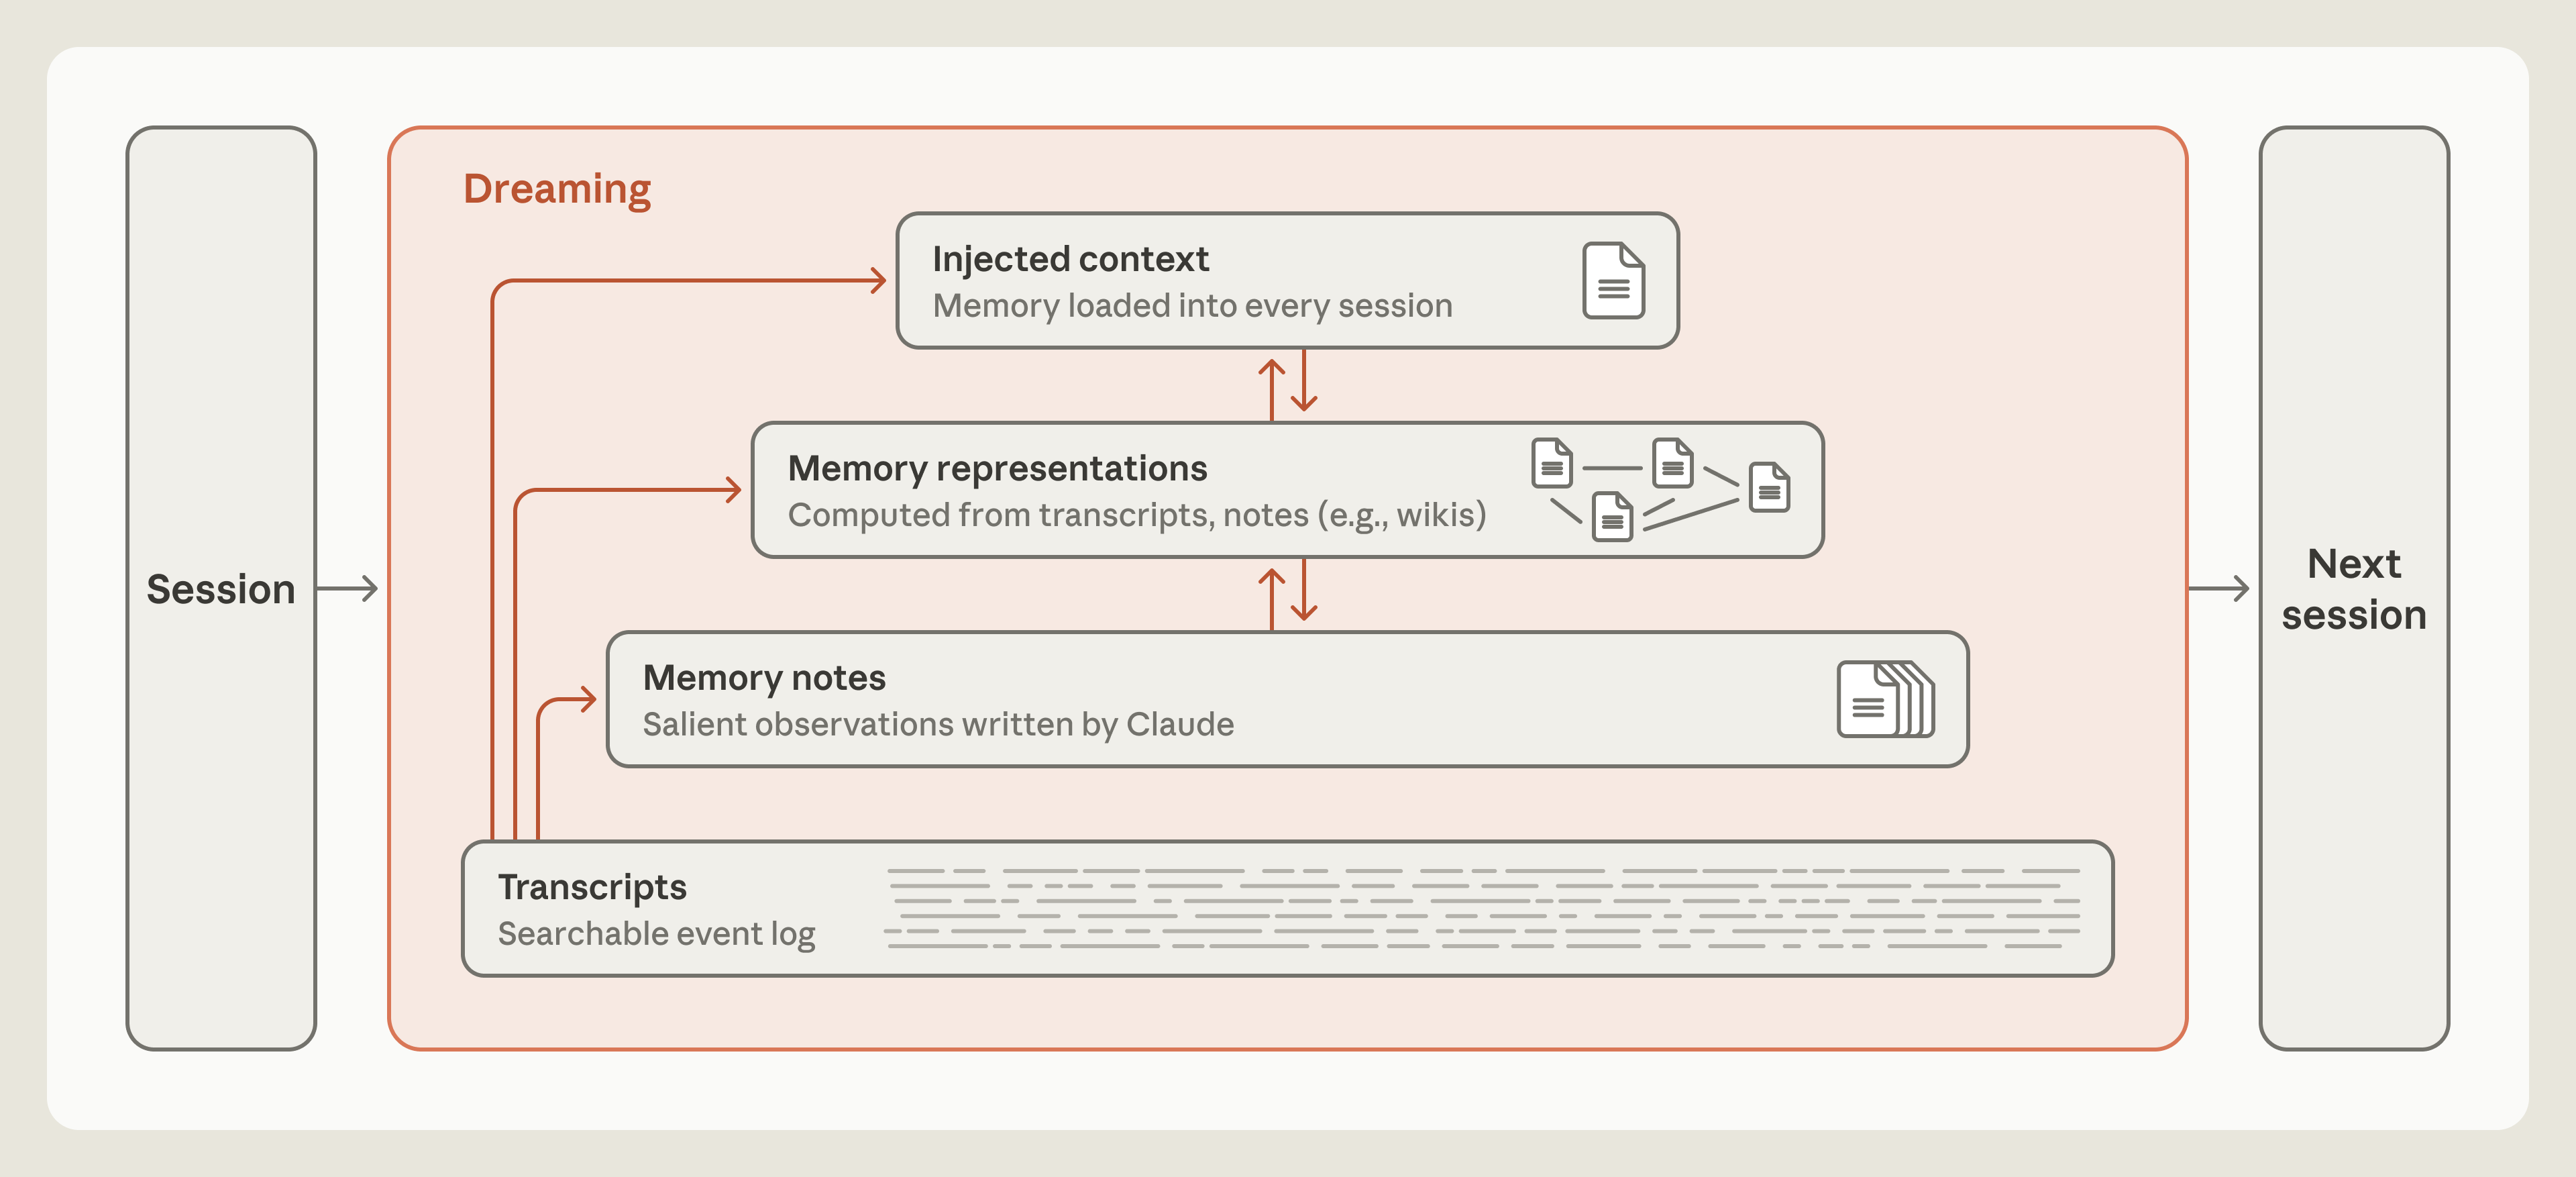
Figure 1|全文骨架:左边是本次会话,右边是下一次会话,中间四层自下而上收敛,dreaming 的箭头从 transcripts 出发贯穿各层,并在相邻高层之间双向流动。原文 caption:Claude can use dreaming to organize memory. 图源:Anthropic Engineering。
这两层的关系,我几乎没有陌生感。做知识管理这些年,反反复复要权衡的就是这件事——哪些该推到人面前,哪些该等人来找,推错了代价有多大。
injected context 是「推」。它由 agent harness 在每次会话开始就加载,Claude 不用搜索,甚至不需要知道有东西可搜。好处是零成本取用,坏处也全在这里:它占着宝贵的 token;一条写错的 note 会被带进之后的每一次会话;加载了也不保证模型会照做(Claude Code 的文档就提醒过,更长的指令文件反而降低遵循度)。Anthropic 的处理很克制,Claude Code 的 auto memory 每次只加载 MEMORY.md 的前 200 行或 25 KB,剩下的留给链接。那 200 行不是知识仓库,是一张索引卡。
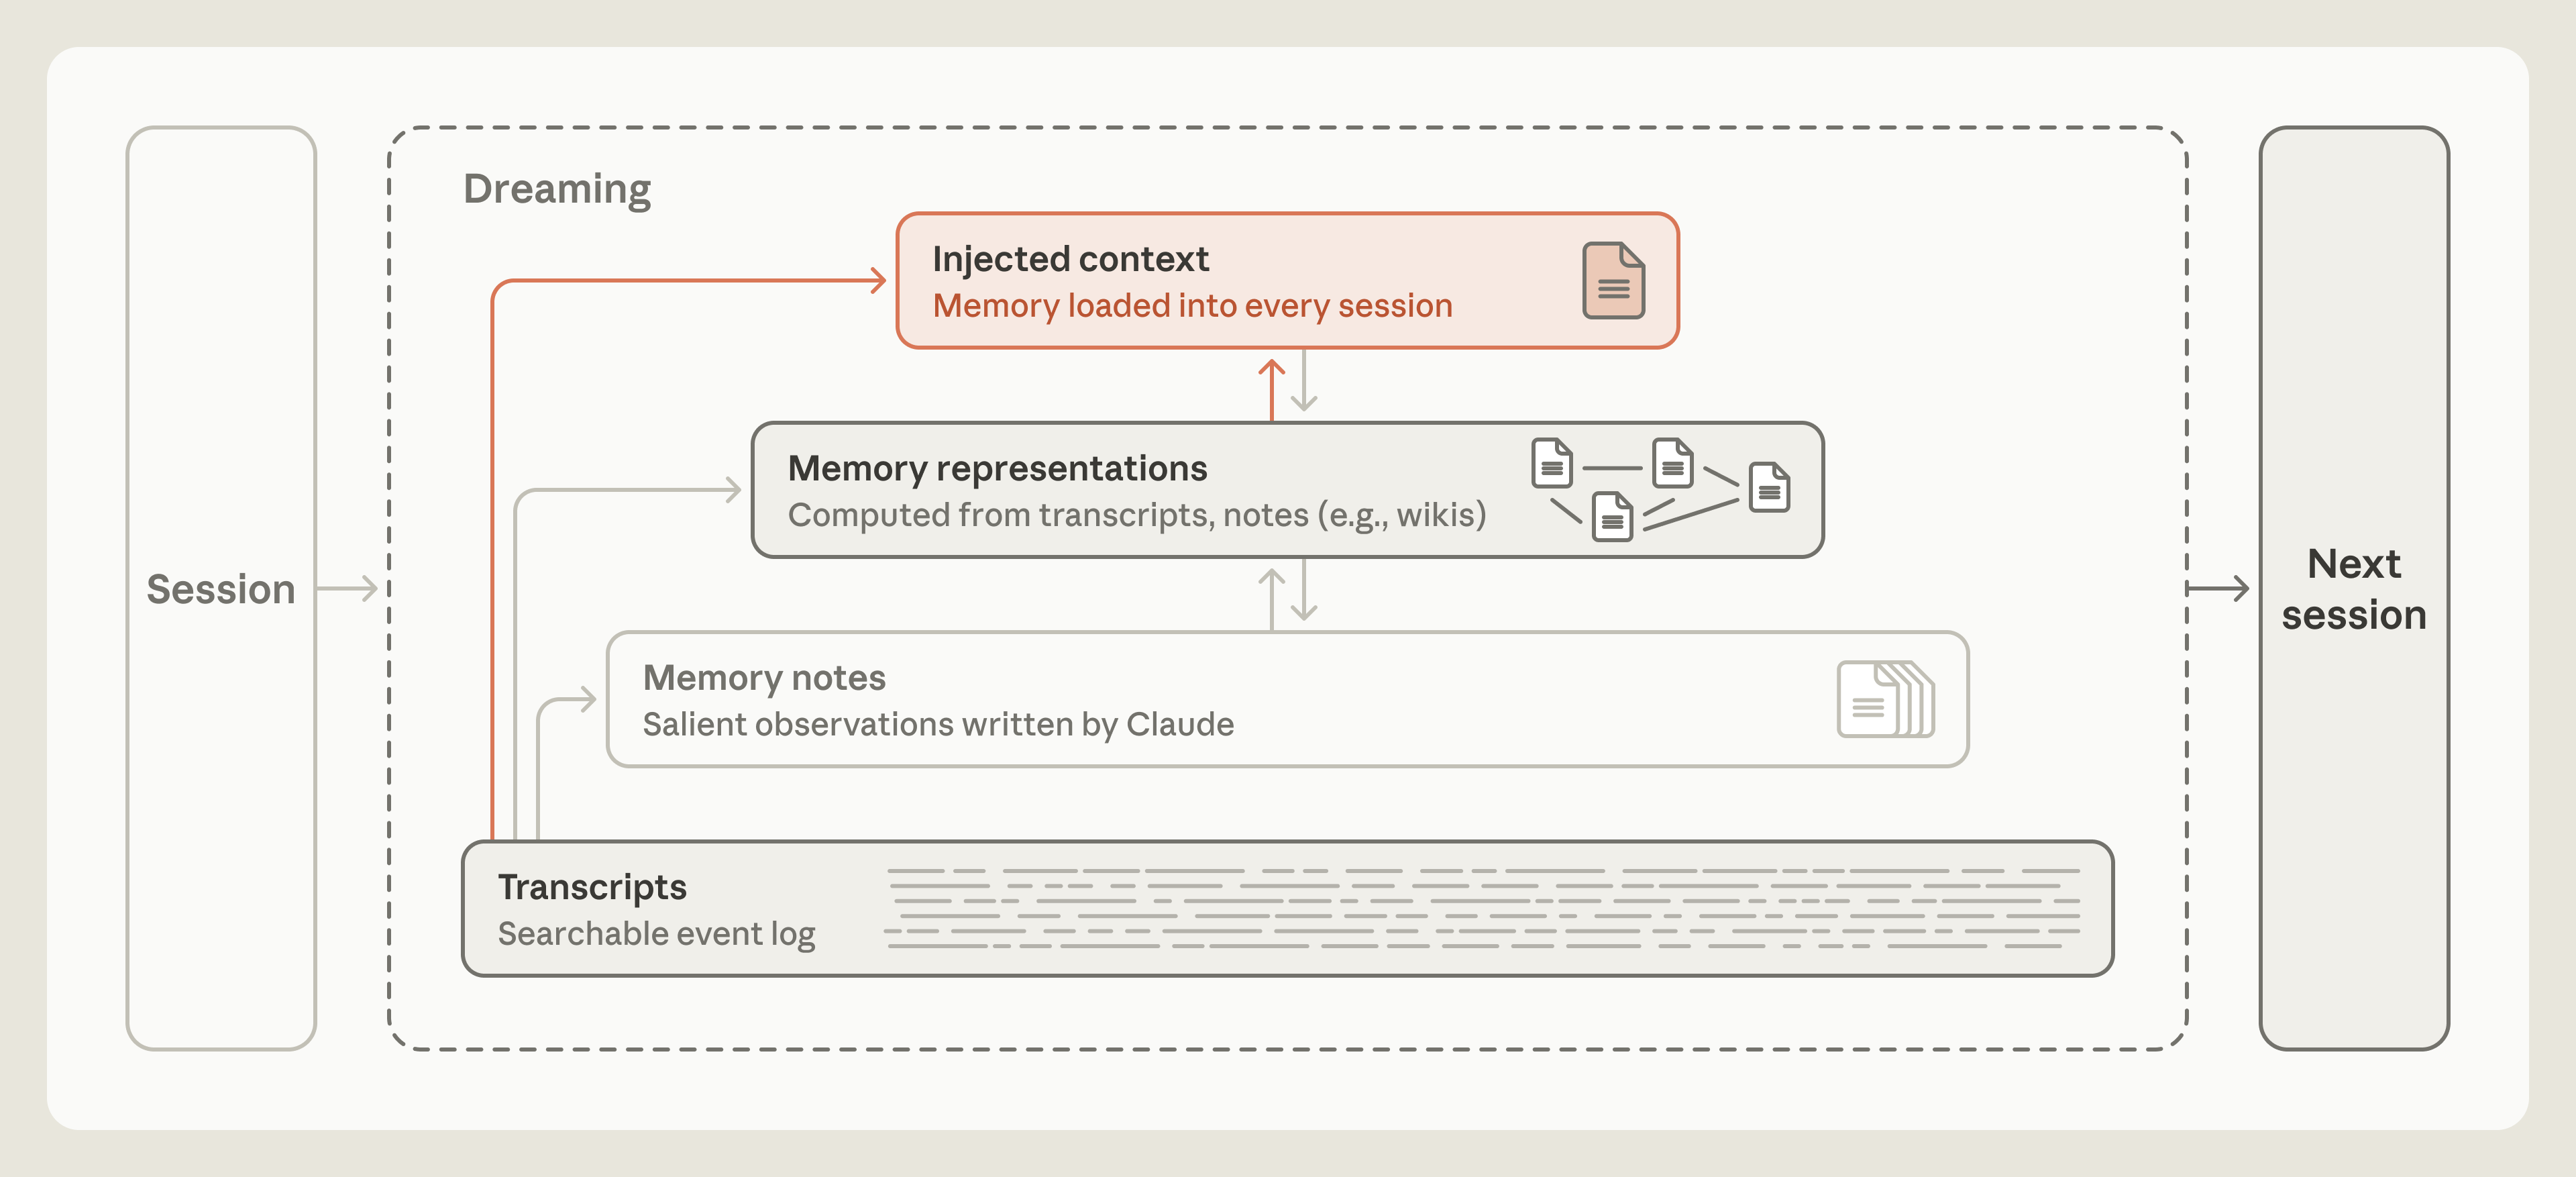
Figure 13|顶层被点亮:dreaming 从 transcripts 与 representations 向上写入 injected context,由它带进下一次会话;下面各层则按需读取或搜索。原文 caption:Dreaming can write to the top of the memory hierarchy. 图源:Anthropic Engineering。
顶层越贵,越要做减法。减下来的细节去哪儿?去 wiki。
原文对 wiki 的定义我很喜欢:由 Claude 编写和维护的一组页面,围绕一个主题汇集它已知的内容,并链接到其他笔记;这些链接本身就构成一张地图,让模型能筛选记忆、在需要的时候高效找到它。这里出现了一次很关键的角色转换——常驻上下文负责「一直知道」,wiki 负责「找得到」。一个管当下,一个管长期。
我在企业里见过太多把这两件事混在一起的做法:什么都往首页塞、什么都往群里发、什么都要「全员必读」,结果是所有人都在场,却没人找得到东西。Anthropic 用 token 成本把这道边界算清楚了,我们用权限和版本算了十五年,结论其实一样。
从 Context 到 Knowledge Wiki 这一段,是我读得最慢的部分。还有一句话我划了线:记忆有时是一种预测。写下一张笔记,是在赌这个模式将来还成立;写下一件已核实的事实,是在赌未来的会话愿意直接依赖它、不再复核。这句判断解释了后面所有机制为什么存在——预测会错,所以得有东西在事后纠。
做梦,其实是一条反着走的知识生产线
dreaming 这个词不是 Anthropic 造的,它接在 Letta 与 UC Berkeley 提出的 sleep-time compute 上:让模型利用交互之间的空闲时间重组已有的 context。Anthropic 把它落到记忆上,做了五件事。跟我们这条主线最相关的是其中三件——纠正错误、构建 wiki、把高价值知识上浮为常驻上下文。
先说构建 wiki,这是整篇文章里我最想推荐给做企业知识的人看的一段。
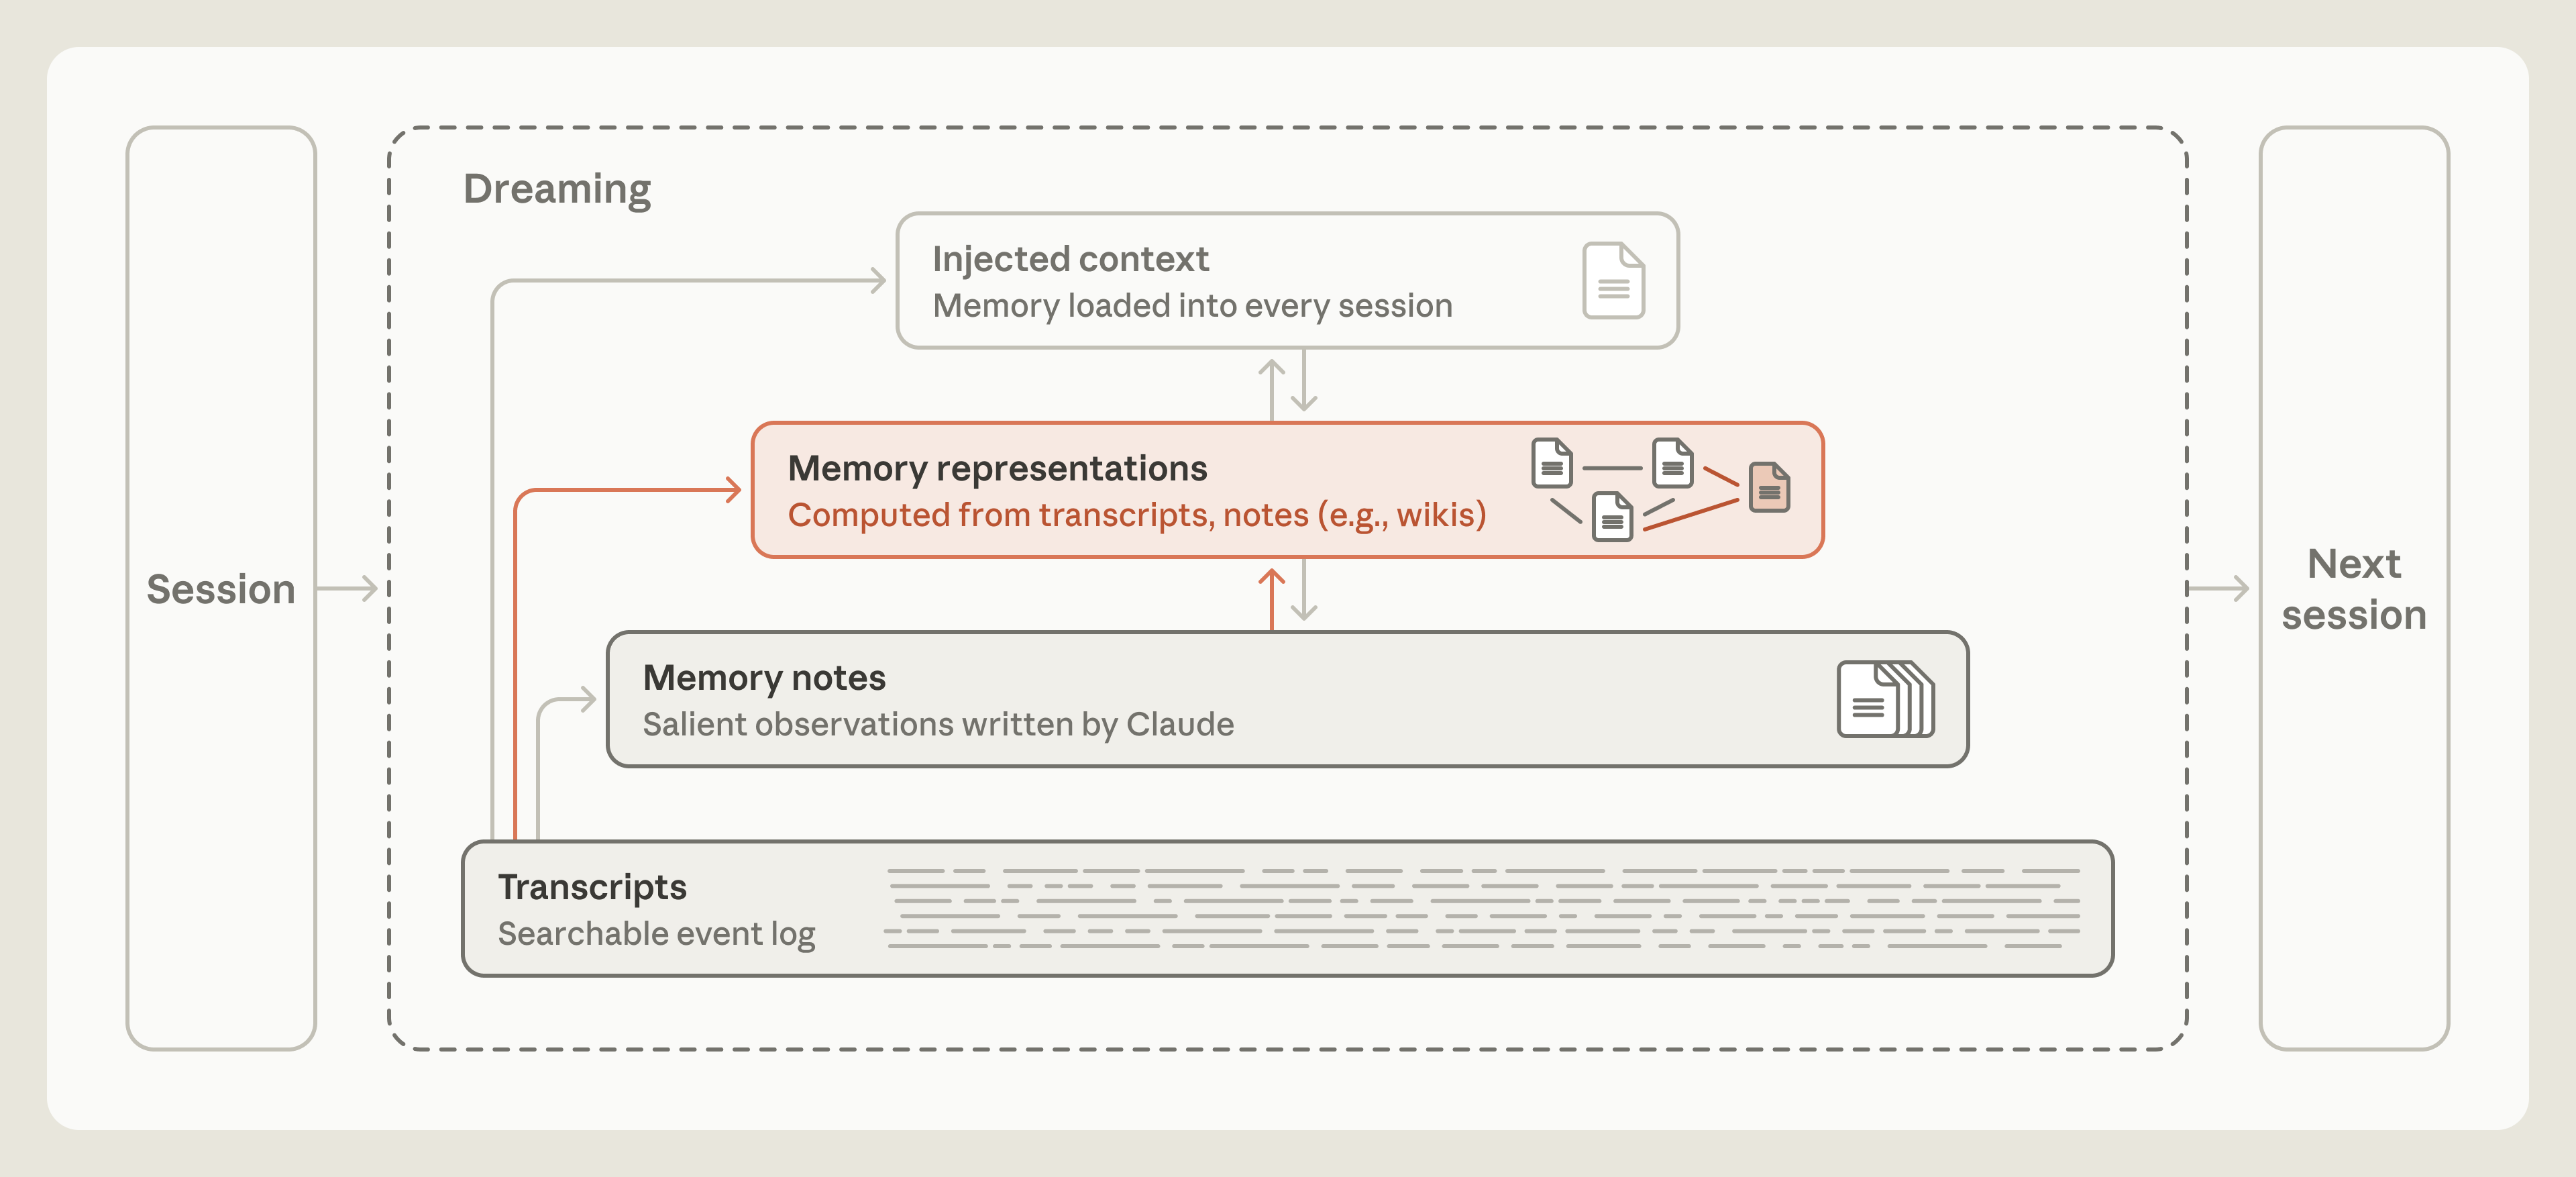
Figure 9|箭头从 transcripts 和 memory notes 指向 representations 层,wiki 就是这一层最典型的形态。原文 caption:Dreaming can build memory representations. 图源:Anthropic Engineering。
Stainless 的内部文档语料约 35 万份文件、4.2 亿 tokens,评测集是 25 个问题。128 轮 session 里,Opus 5 agents 探索文件、写或纠正链接页、合并重复、核对来源,靠一个共享日志协调进度。示例 wiki 从第 2 轮的 103 页、766 条链接,长到第 128 轮的 222 页、12,893 条链接。作者的比喻很准:一开始像新员工,dream 得越多,那张知识地图越像一位老员工画出来的。
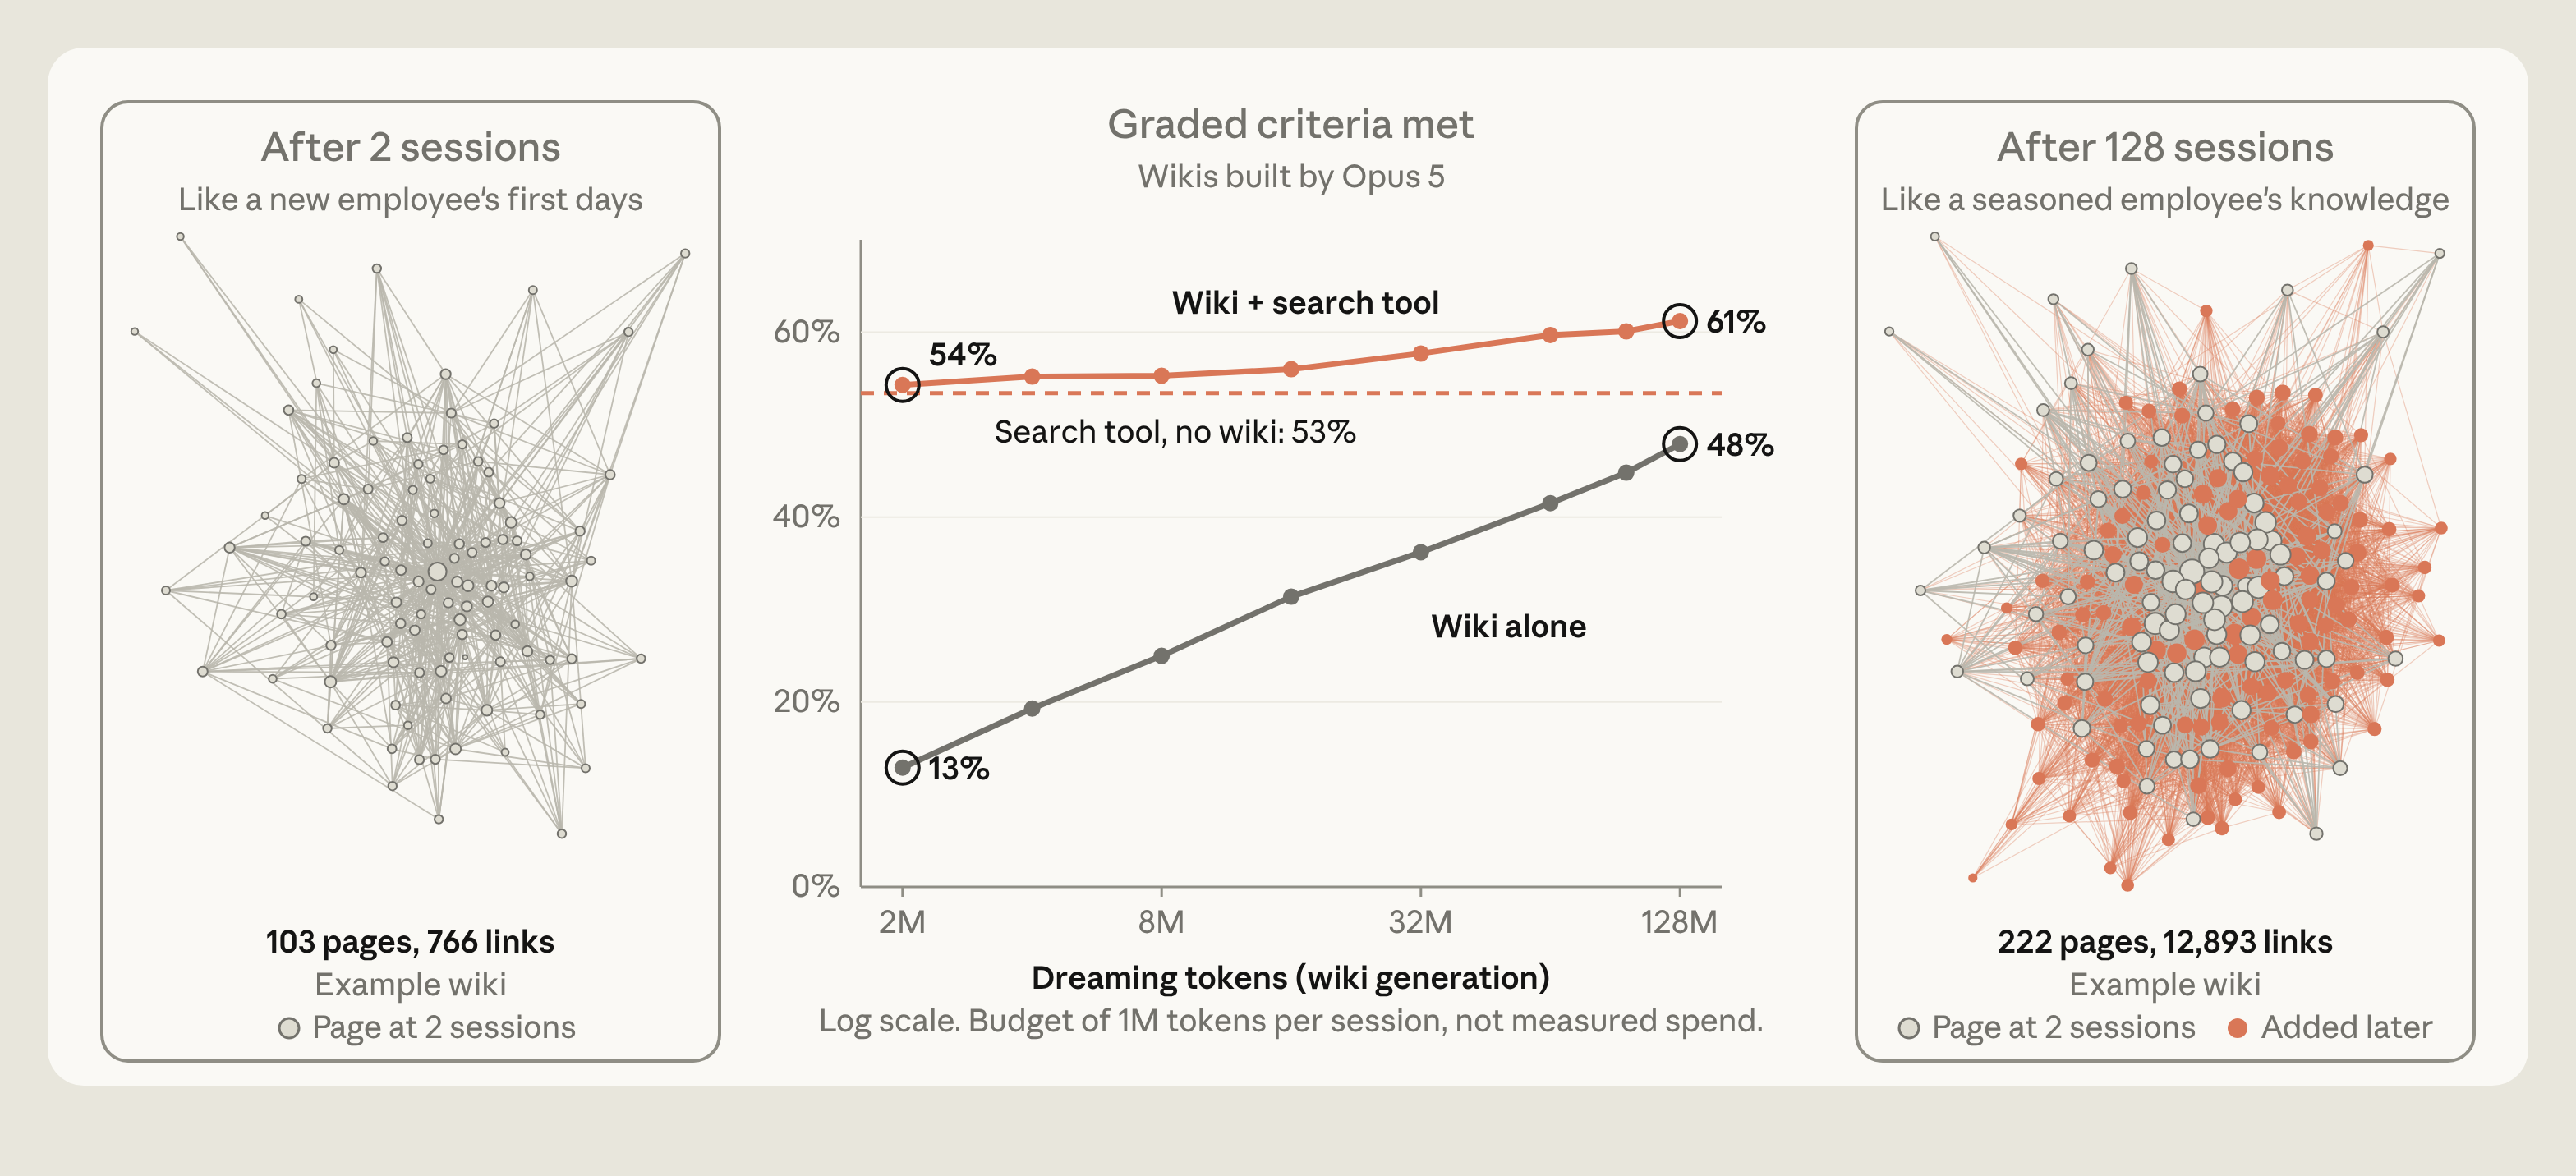
Figure 10|左右是同一个 wiki 在 2 轮与 128 轮时的页面链接网络,中间是 25 个问题的得分曲线。这组曲线我在下一节还会再讲一次,这里先看两张网络图:形状变了,密度也变了。原文 caption:Center: scores on 25 questions about a corpus of documents from a company as Claude built wikis over sequential sessions. 图源:Anthropic Engineering。
我盯着那组链接数看了很久。103 页到 222 页只翻了一倍,链接却从 766 长到近 1.3 万——真正长出来的不是内容,是内容之间的关系。企业里所谓知识沉淀,难的地方从来不在写下来,而在把散落的判断连起来、重复的分清谁算数、断掉的补上。这件事过去靠人,靠季度整理,靠某个快要离职的老员工;现在它变成了空闲时段里可以持续跑的一段算力。
再说纠错和上浮,它们决定了这张 wiki 值不值得被信任。
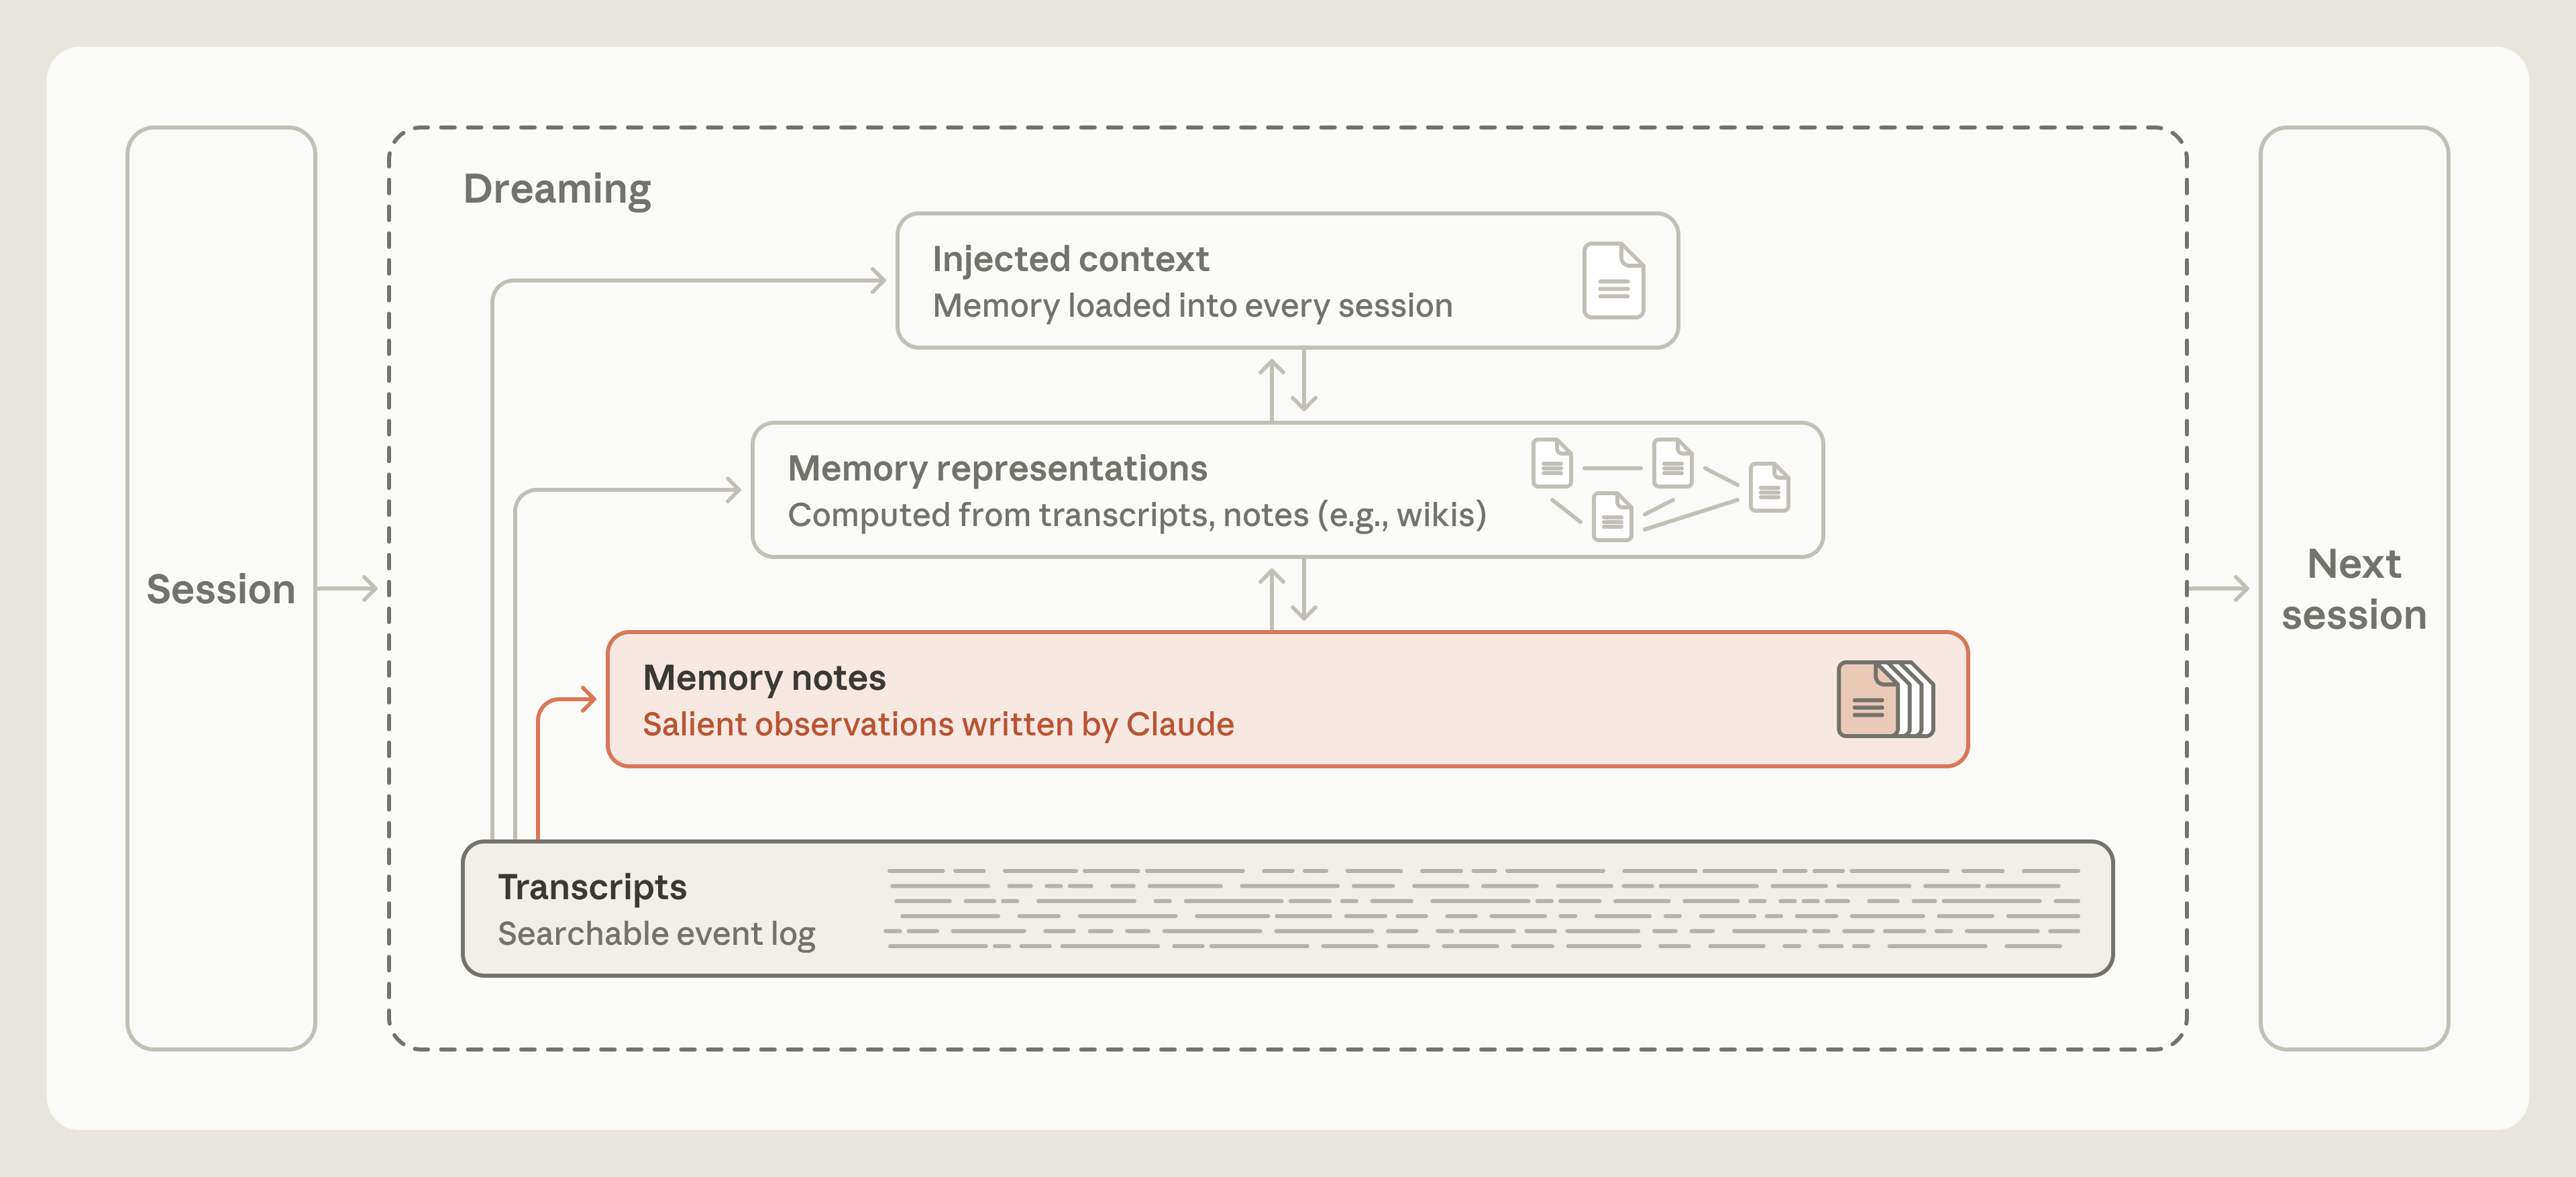
Figure 6|一条从 transcripts 指回 memory notes 的箭头,让原始日志当裁判。原文 caption:Dreaming can correct mistakes in memory. 图源:Anthropic Engineering。
纠错的做法是把 note 拿回原始 transcripts 前对照,让日志当裁判。Mt. Moon 那个例子讲得很生动:Claude 把宝可梦中心的方位记反,宣布「月见山在我身后」、写下「月见山已完成」,接着从单向悬崖掉回原路;导航工具没显示掉落,它又把原因误判成「我向西走过头了」。dreaming 拿 session transcript 比对,抓出错误并改写 note。修正之后,Claude 在第 1,935 个动作抵达 Cerulean City;未修正的那一路掉了三次,最后写下「我打算停下,而不是一直绕圈」;完全不给记忆的那一路,同样没到。错的记忆比没有记忆更消耗,只有被纠过的记忆才算资产。
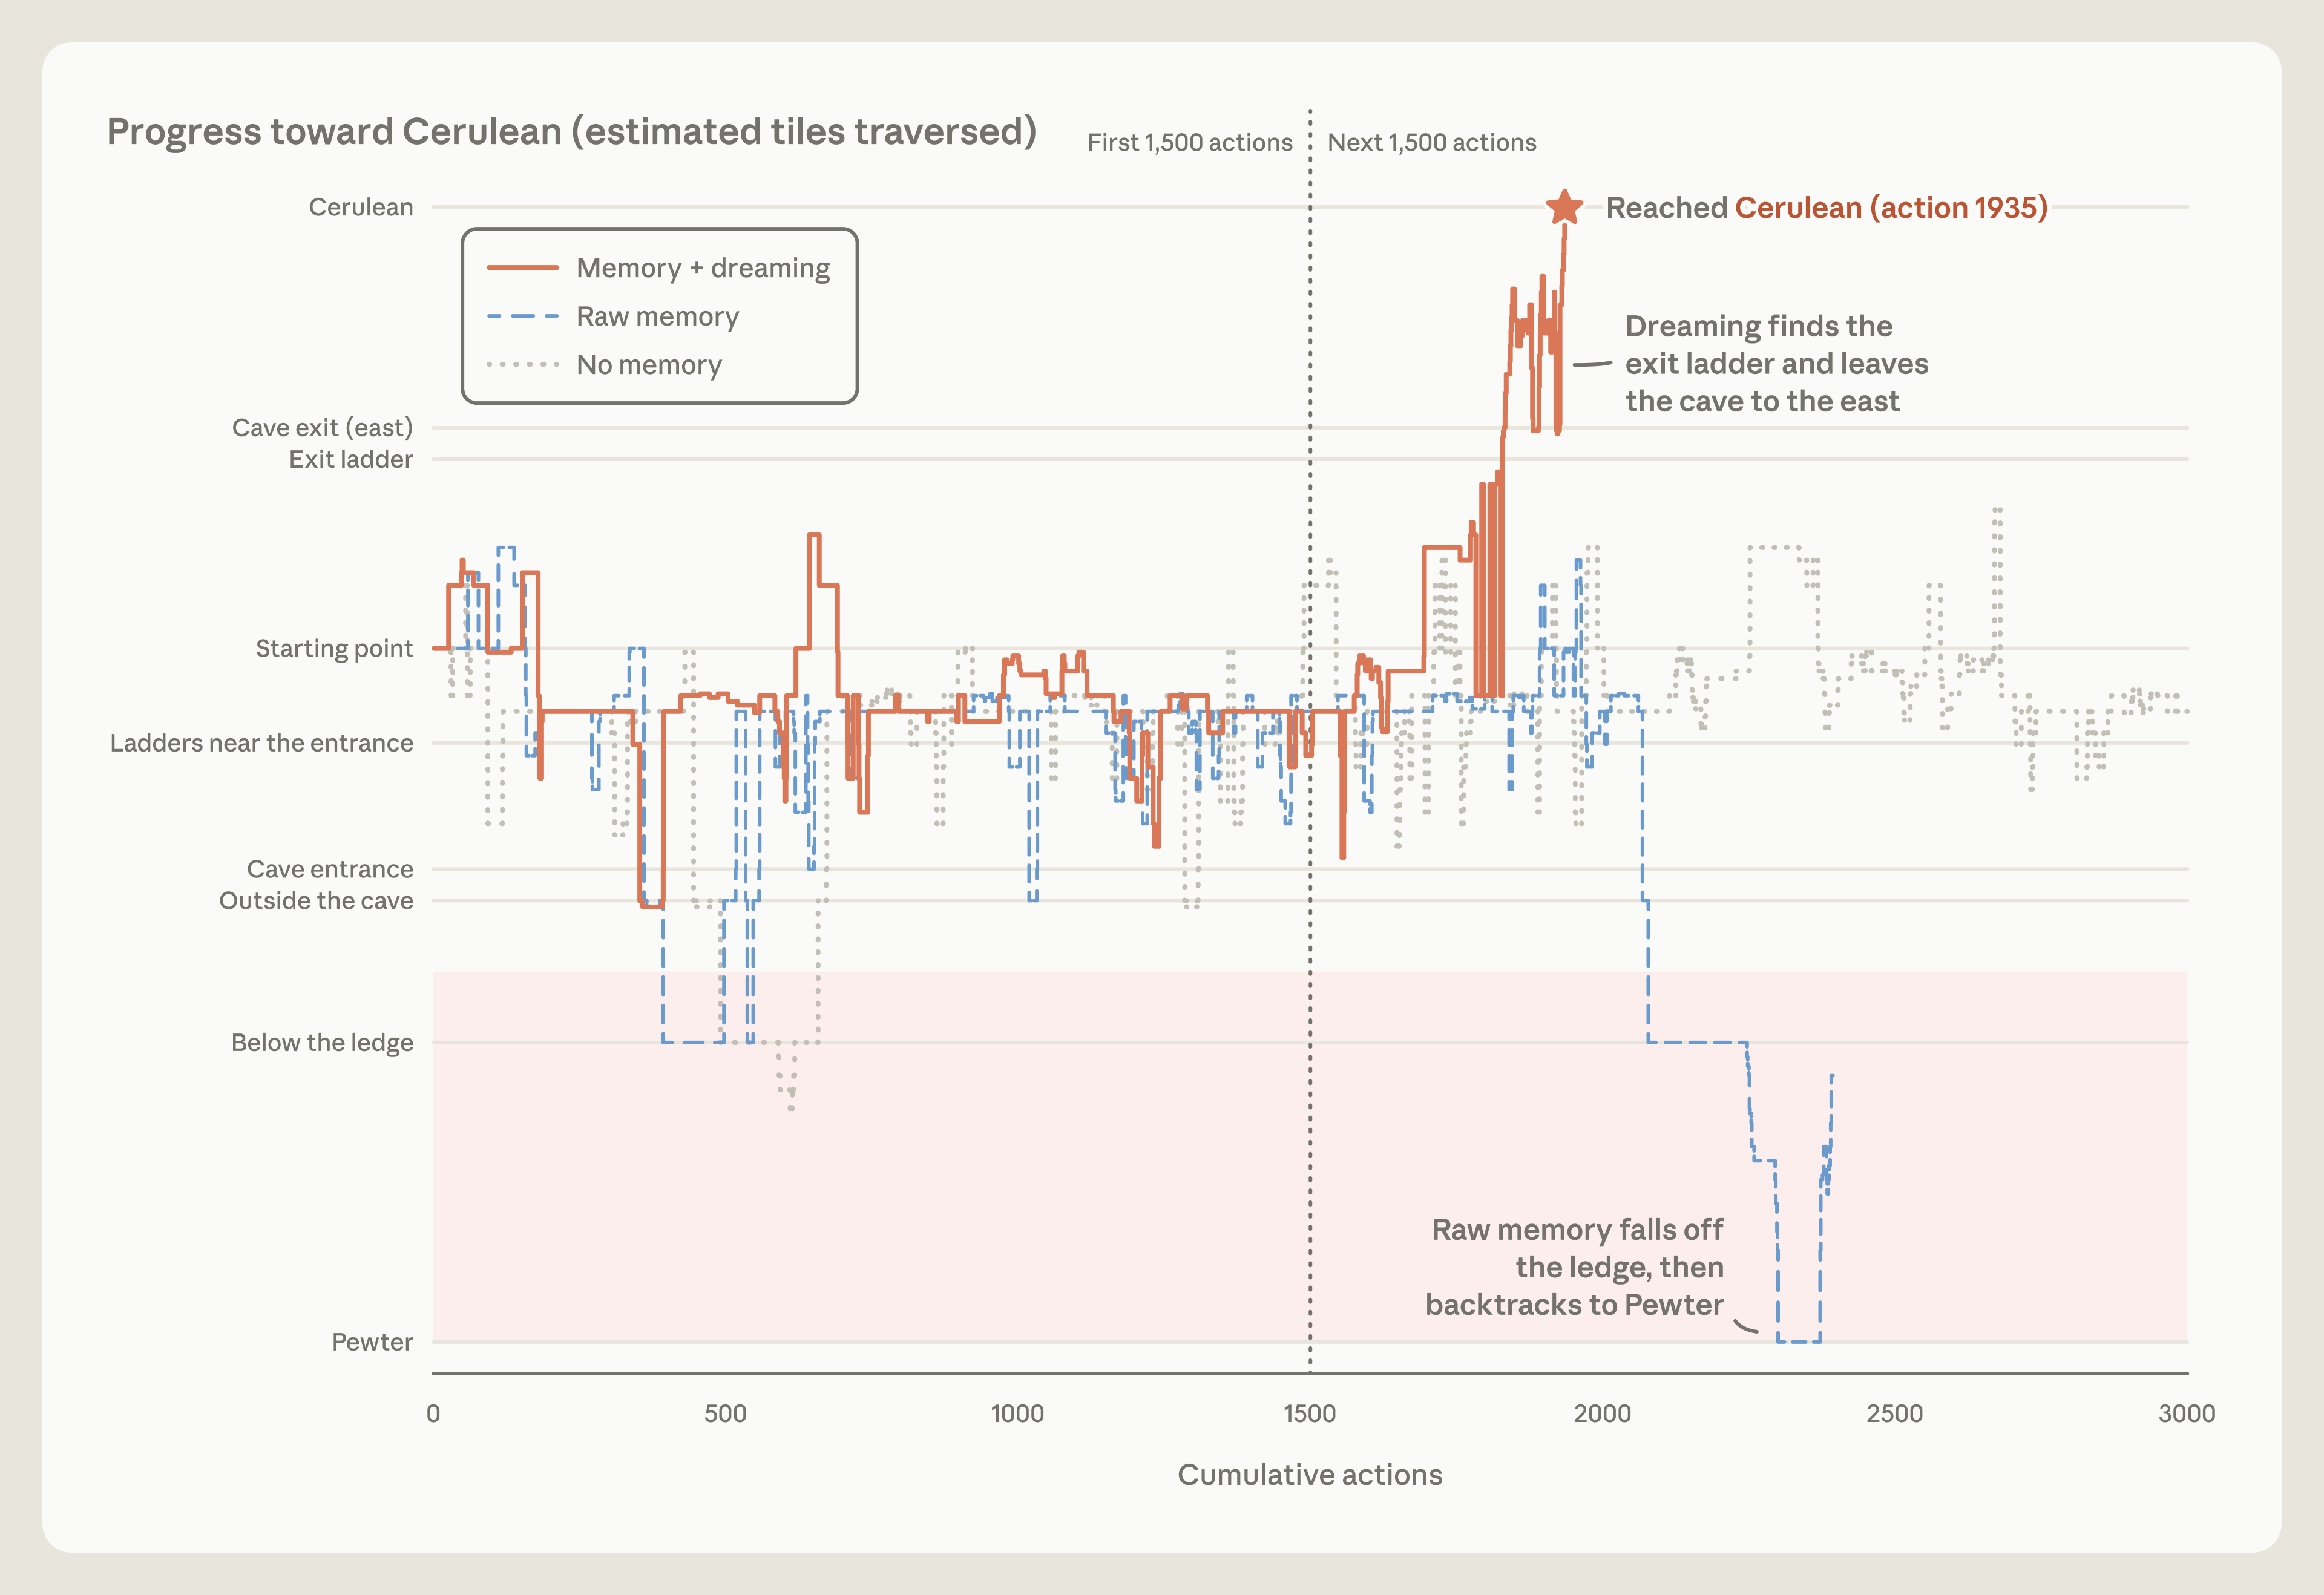
Figure 8|横轴是累计动作数,纵轴是朝 Cerulean 的推进:只有「记忆 + 纠错」那条线翻过了山。原文 caption:Dreaming corrects the memory, and Claude goes back into the cave and reaches the next city. 图源:Anthropic Engineering。
上浮是反方向的动作:把少数高价值的笔记提到顶层常驻,把细节下移、只留下链接。一边把散的连成网,一边把网上最要紧的结提到手边。
三件事合起来看,我的感受有点特别。来源核对、编目、去重、分级、发布——这不就是我做了十五年的那套活吗。只是过去它叫知识治理,节奏是季度,责任人在某个岗位;现在它叫 dreaming,节奏是空闲时段,执行者是模型。名字全换了,要解决的问题一个没变:让向后理解过的经验,变成未来可以直接取用的结构。
三个数据,让我停下来的时间最长
原文有五组评测,我只挑三个说,因为它们都指向同一件事:瓶颈不在存,在取。另外两组(学习回路怎么闭合、该不该替强模型定规则)偏的是单个模型怎么变强,跟企业长期记忆这条线离得远,这里就不展开了,图版附在文末备查。
第一组是 wiki 和搜索的关系,就是上面 Figure 10 中间那三条曲线。Stainless 实验里,只用搜索工具稳定在 53%;只用 wiki,随着 dreaming 从 2 轮扩到 128 轮,从 13% 升到 48%;两者一起用,从 54% 升到 61%,而且每题省下约 20,000 tokens。作者甚至提出,可以把 transcript search 视为记忆的地基。这个结论我很认:表征不取代检索,它给检索一张地图——先知道该往哪儿找,再去找。上下文工程里最贵的从来不是 token,是找错地方。
第二组是 wiki 挑任务。Harvey LAB 里,24 道并购问题超过一半要跨多份文档组合信息、9 道还要判断或算术,用 wiki 得 87%,只靠搜索 73%;另一组 57 项评分标准大多能在单份文档里检索到,wiki 就没带来明显收益。
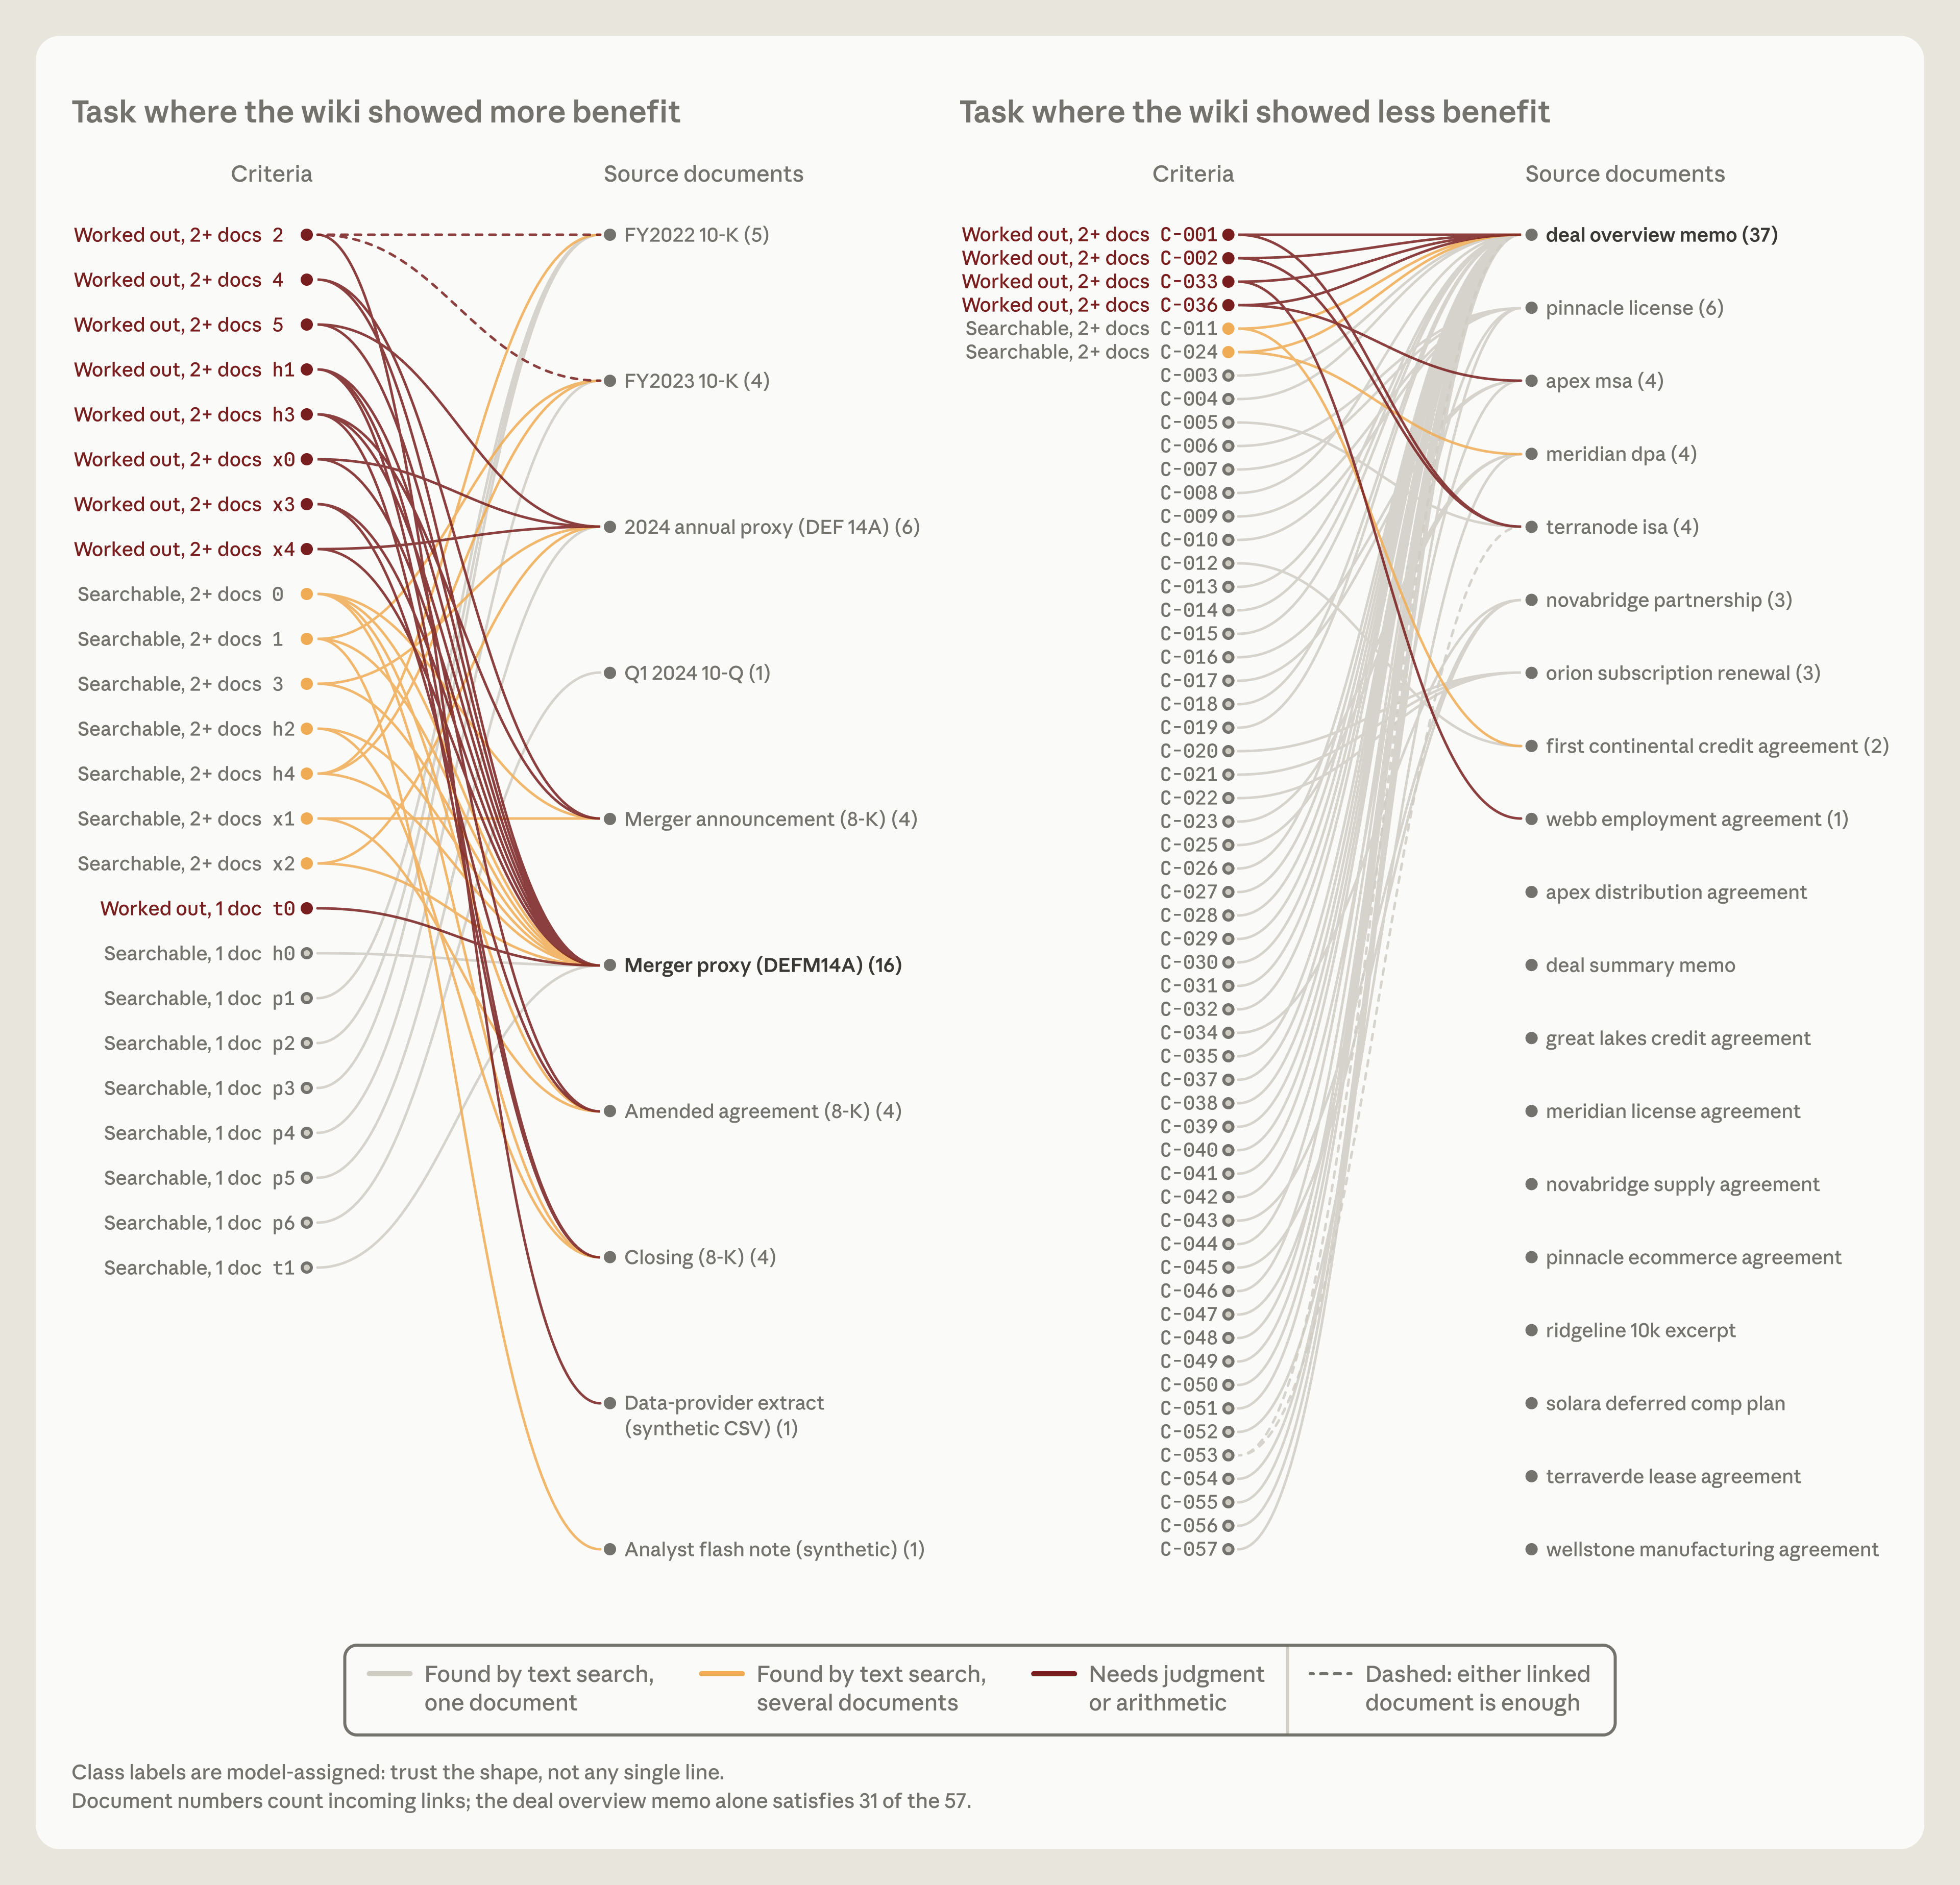
Figure 11|把评分项连到它需要的源文档:左边多数评分项连到两份以上文档,wiki 有用;右边多数只连一份,wiki 帮不上忙。原文 caption:Each panel lists what was graded (left) and the source documents needed to meet each one (right). 图源:Anthropic Engineering。
更扎心的是那个反例:10 份文档、115 KB 的原始语料,被建成 68 页、255 条链接、203 KB 的 wiki,1.77 倍于原文,有些页面甚至一条链接都没有。作者引了博尔赫斯《论科学的精确性》里那张和帝国一样大的地图——它什么也没抽象掉。
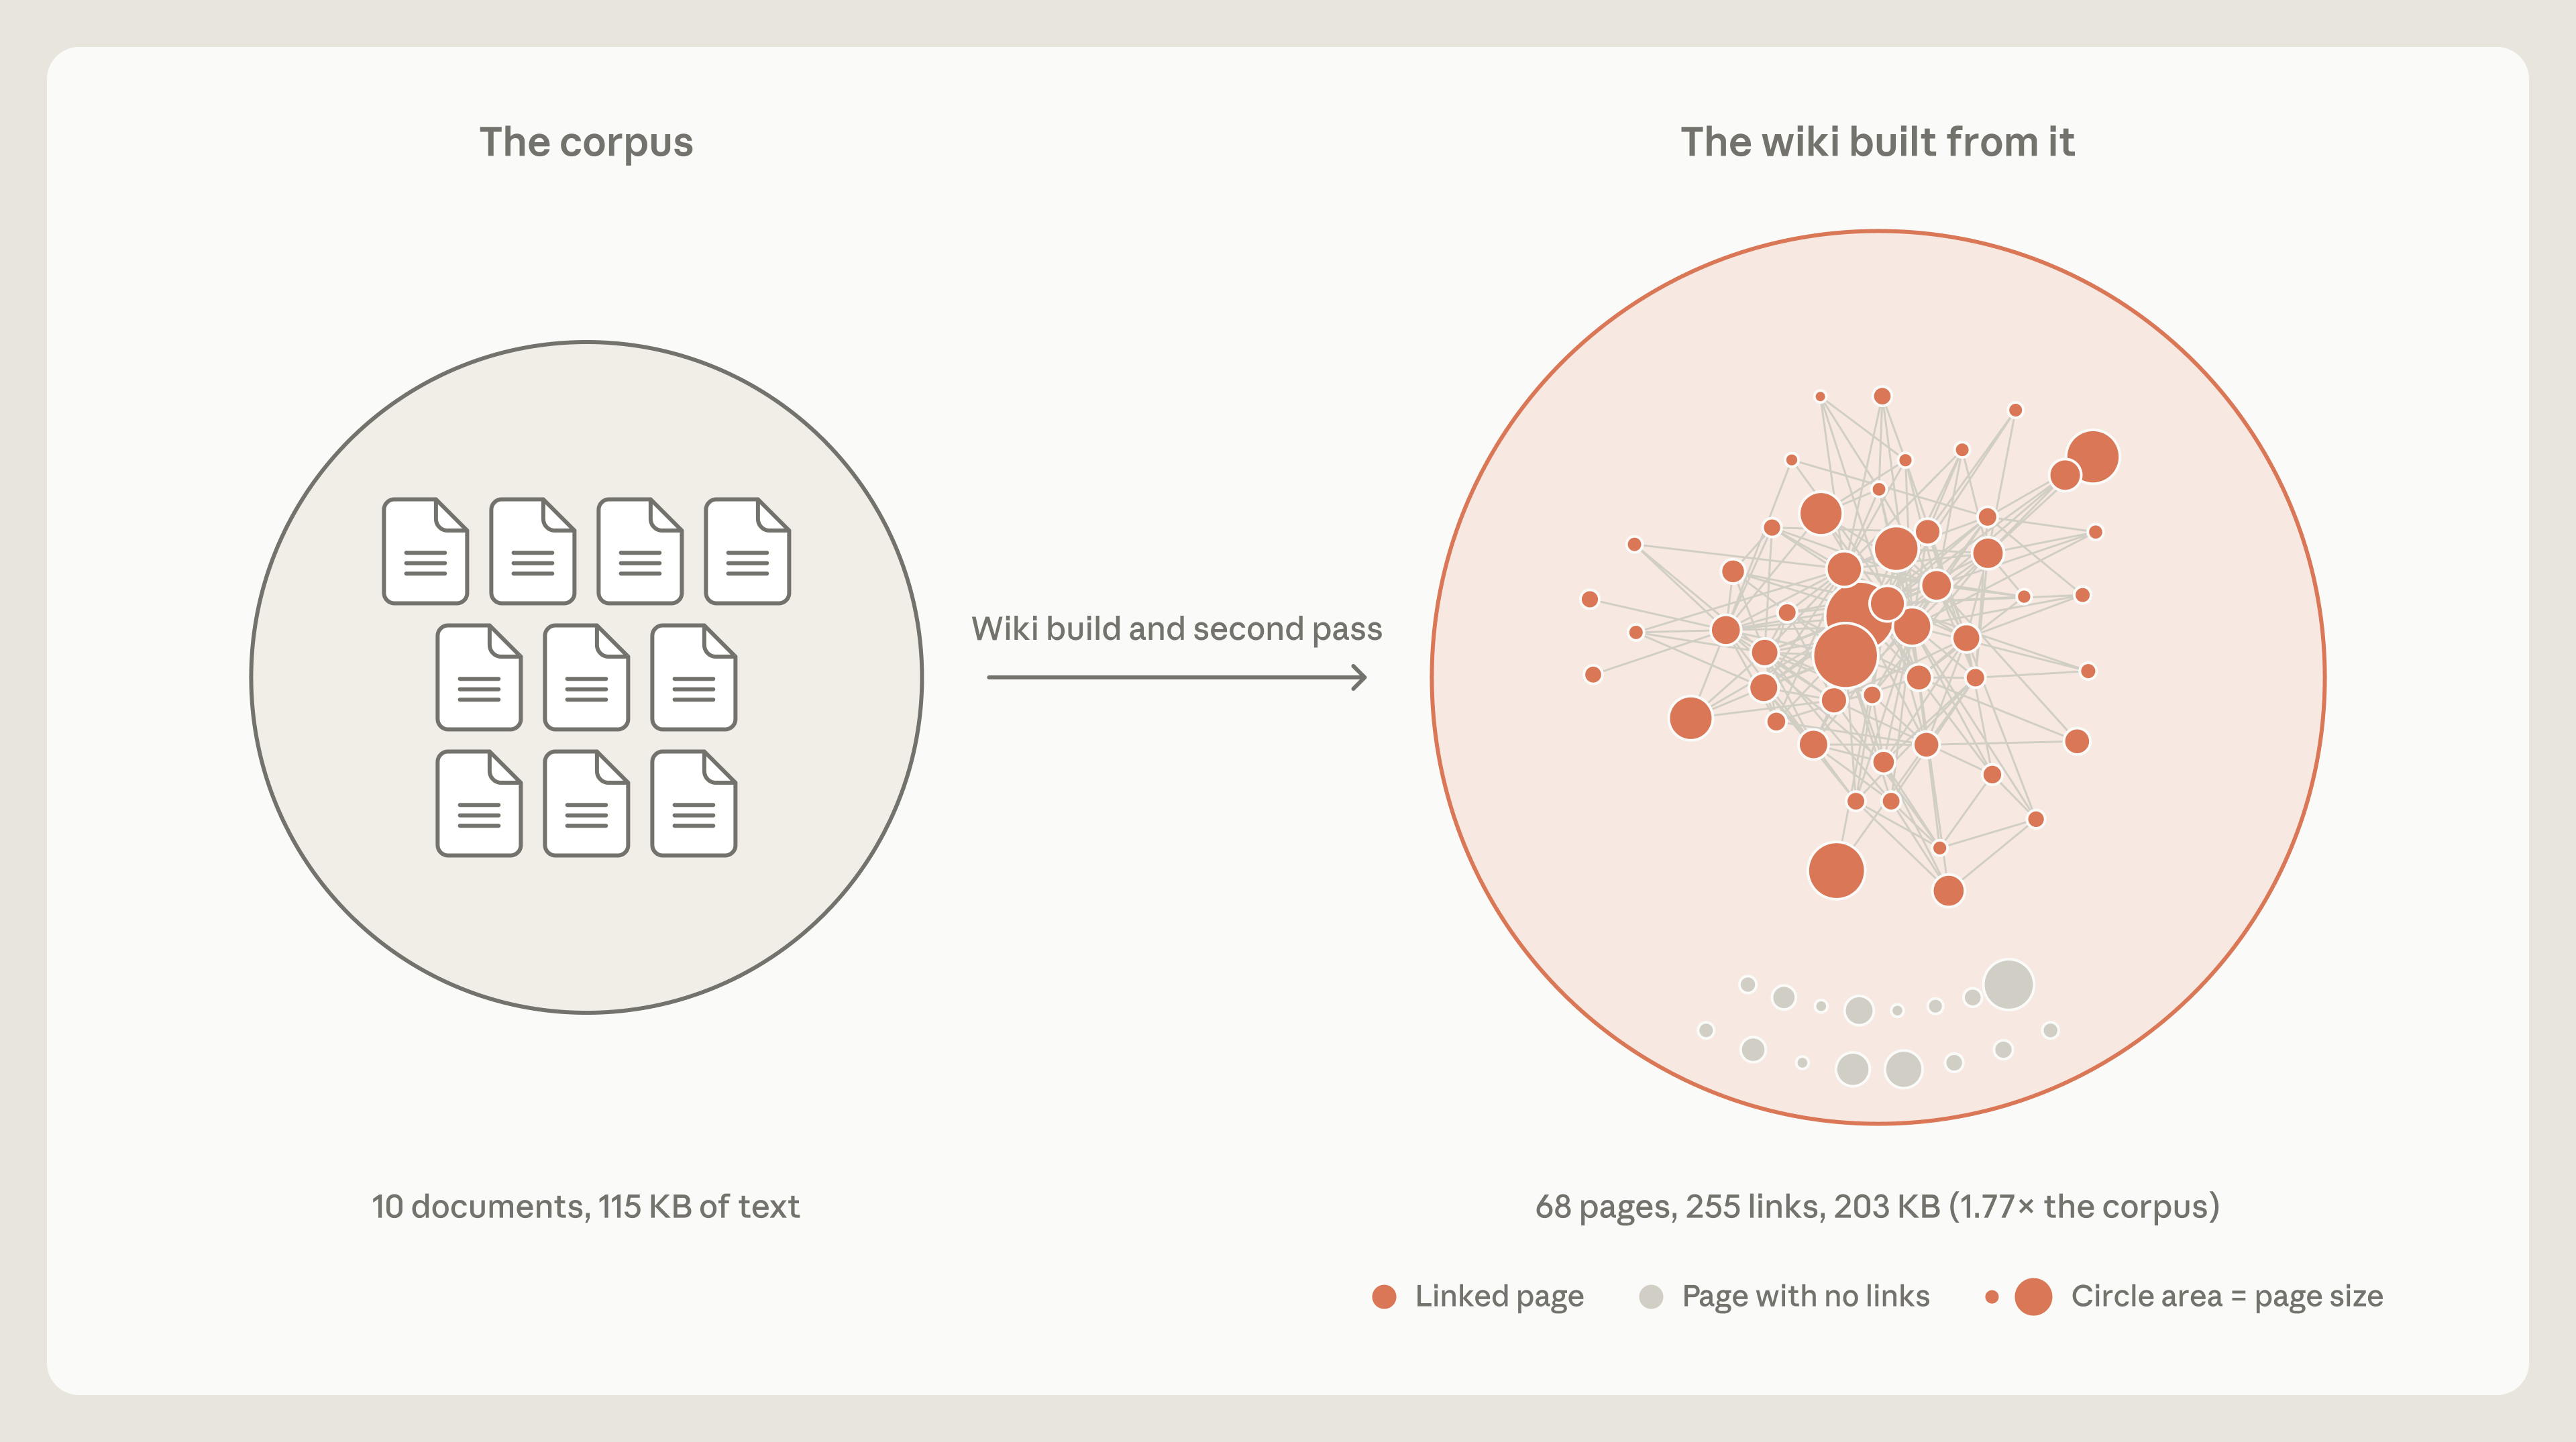
Figure 12|115 KB 的语料长出 203 KB 的 wiki,1.77 倍,还有页面没有任何链接。原文 caption:The wiki grew to be larger than the raw files. 图源:Anthropic Engineering。
这一条我读得最不是滋味。这些年我见过太多号称「建了知识库」的项目,本质就是把文件搬了个地方。页面多了、体积大了,但没有任何一页替读者做过判断。Anthropic 用一组数字把这件事量化了:不产生抽象的 wiki,不如不建。
第三组最朴素:约一万步时,Sonnet 3.7 写了 413 个文件、225 个文件夹、977,930 个字符,拿到 1 枚徽章;Fable 5 只写了 10 个文件、43,406 个字符,拿到 4 枚徽章。更刺眼的是,Sonnet 3.7 在那一带开始建第四个「master」记忆文件夹,接下来 17 步里创建 6 个文件、删掉 9 个,游戏里一步没走。维护记忆本身吃掉了行动。
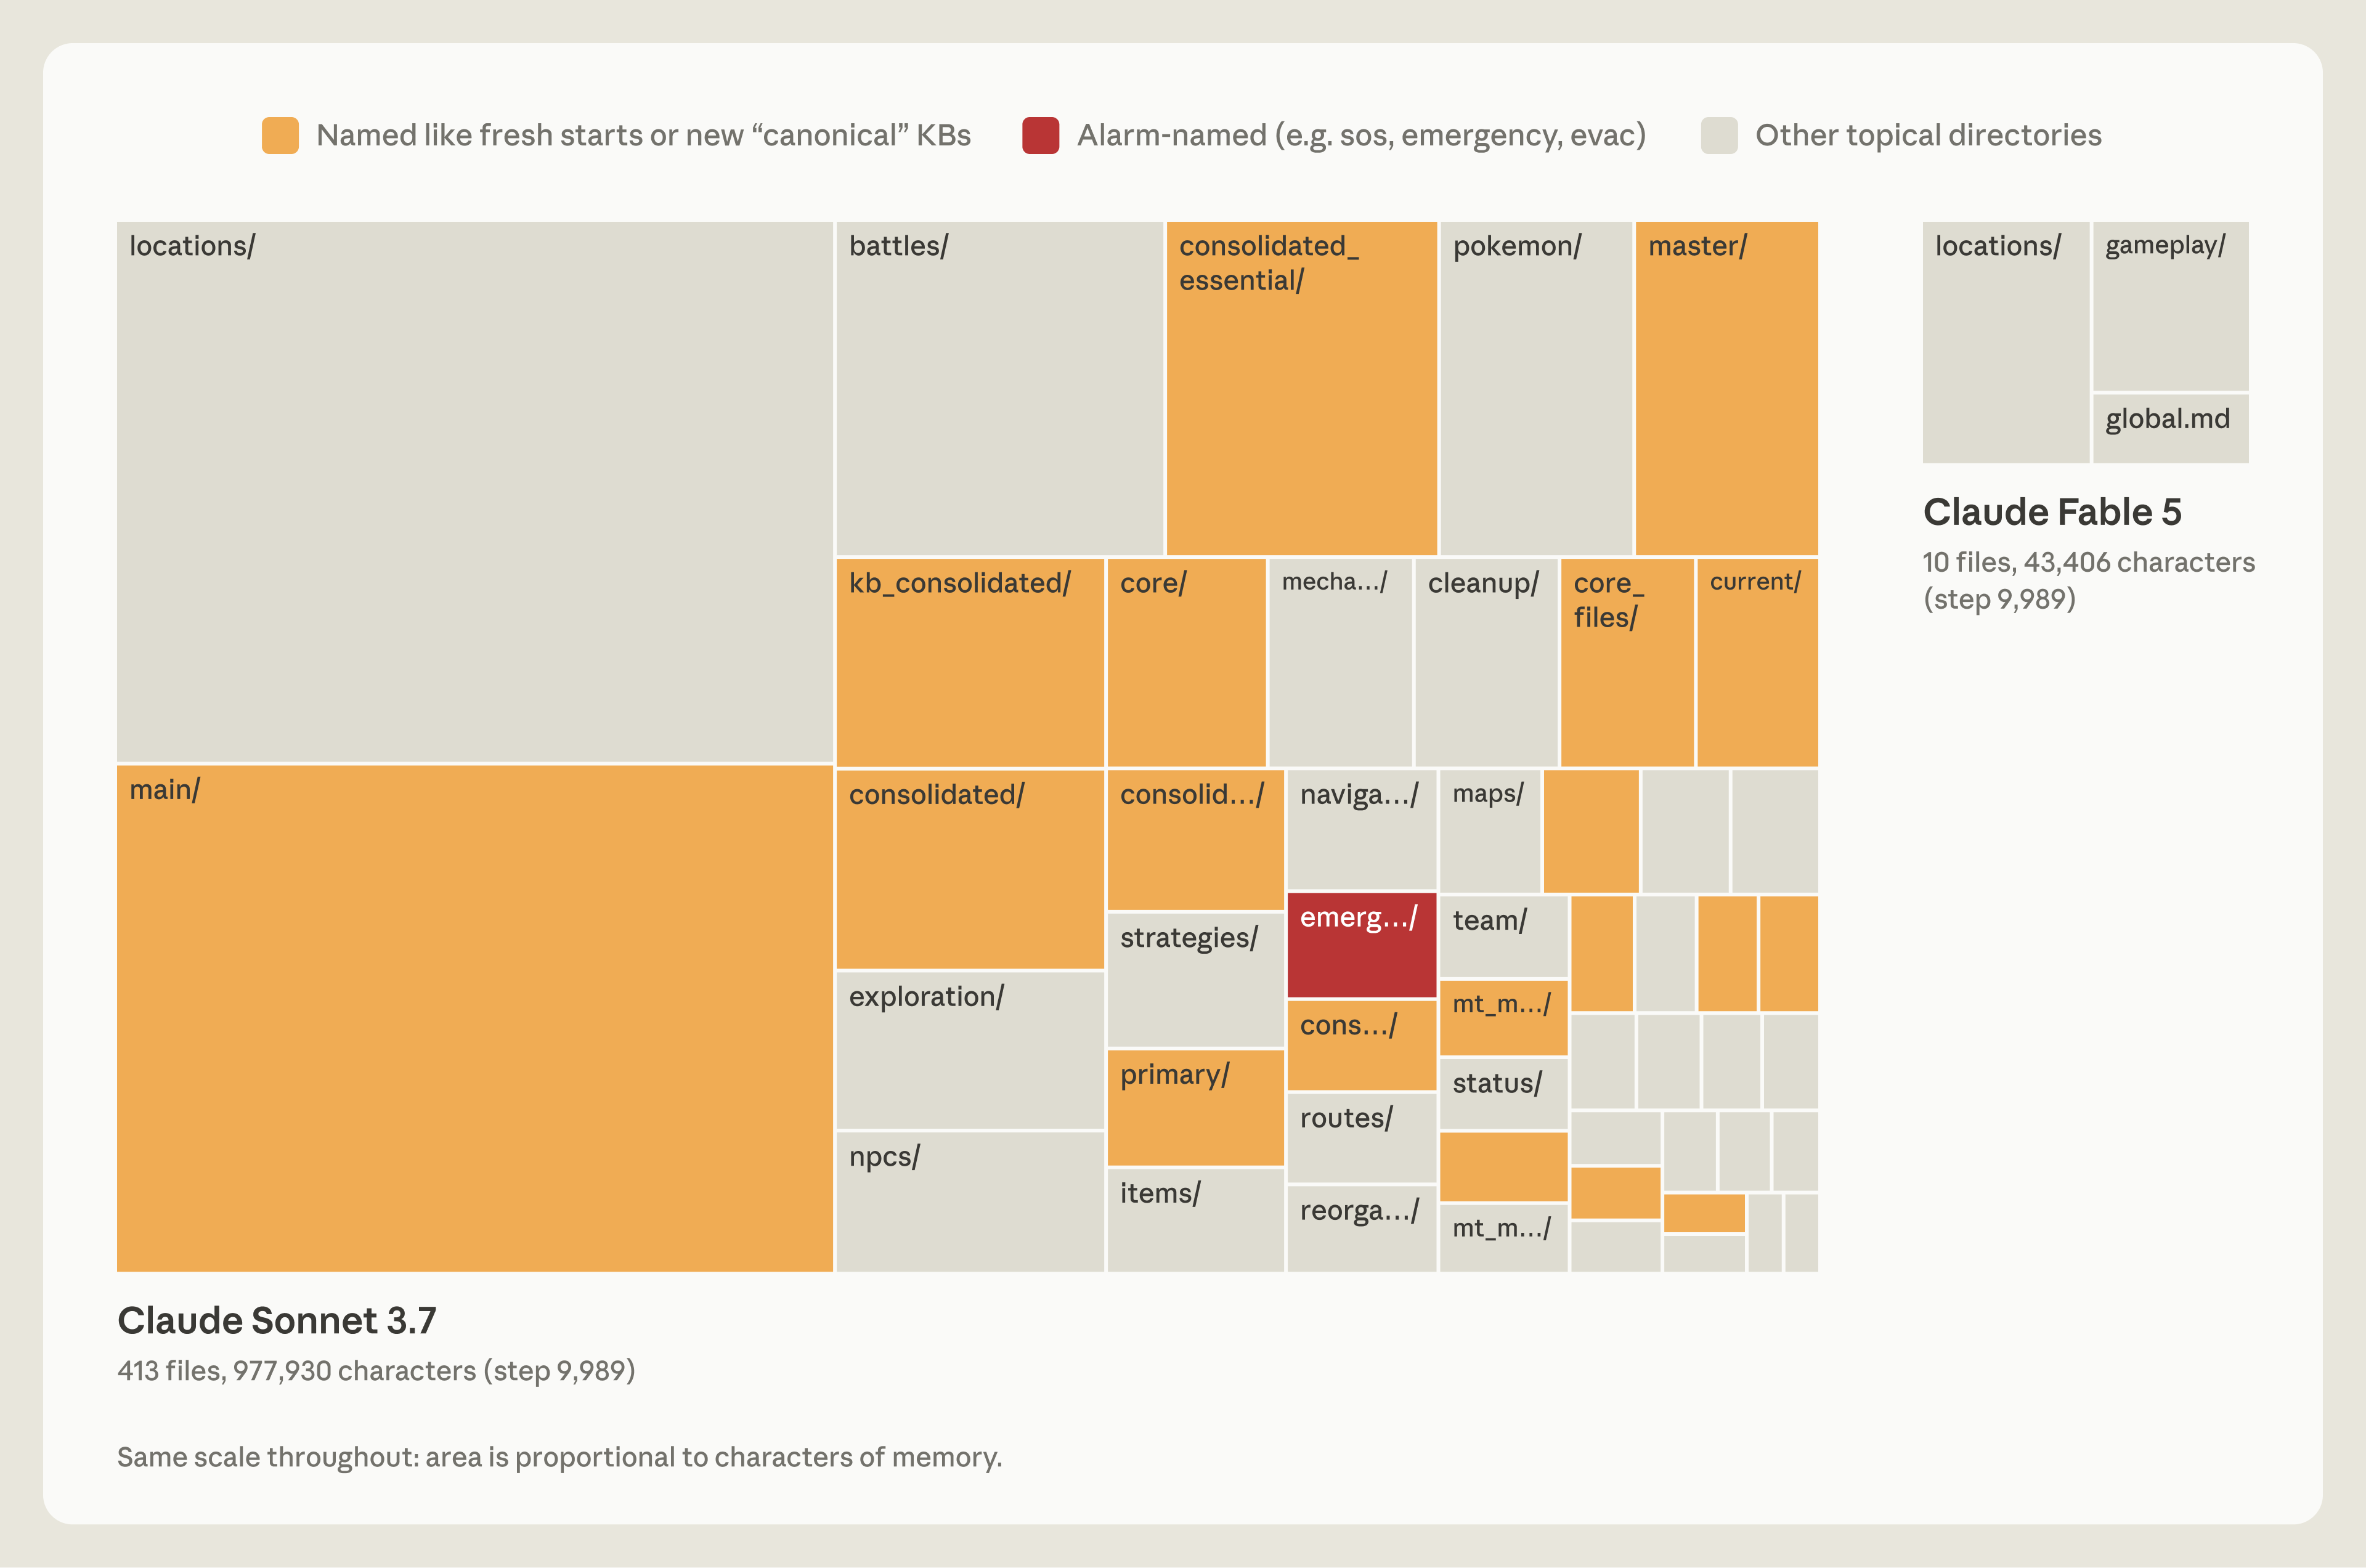
Figure 4|同一比例尺下的两张 treemap,面积表示写下的字符数:413 个文件、977,930 字符对 10 个文件、43,406 字符。原文 caption:Claude’s memory directories for Sonnet 3.7 versus Fable 5 while playing Pokémon. 图源:Anthropic Engineering。
存得多从来不等于记得好。这句话我说过很多年,第一次看见有人用实验把它钉住。
企业长期记忆,缺的不是 wiki
读到最后我留意到一件事:整篇文章的所有权边界,恰好画在一个 Agent 上。transcripts 是它自己的日志,notes 是它自己写的,wiki 是它自己维护的,常驻上下文由它自己的 harness 预加载。一个 Agent 记自己的事,记得准不准,是模型质量问题。
企业里的形状完全不同。很多 Agent、很多人、很多业务系统要共用同一份上下文,问题立刻变成:谁写的、依据哪份原始材料、哪一版有效、哪些人和哪些 Agent 可以看、什么时候到期、被谁改过、出错能不能撤回、能不能一键关掉。原文那句「错误的 note 会被带进每一次会话」,放到企业语境里已经不是模型质量问题,是审计问题。
| Anthropic 的四层 | 企业里的现实对应 | 从单体走向组织时露出的缺口 |
|---|---|---|
| injected context | 每次调用注入的知识片段 | 谁批准的、过期了没有、是否带受众与版本信息 |
| wiki representations | 内部知识站点、SOP、产品手册 | 谁能看、哪版有效、给 Agent 用要不要脱敏、断链谁修 |
| memory notes | 个人笔记、群聊结论、文档里的临时判断 | 没有来源、没有版本、没有责任人,漂移了没人纠正 |
| transcripts | 会话日志、操作留痕、工单、客服记录 | 散在各个 Agent 与系统里,难以作为统一事实基准 |
我更想强调的是这四层之上还有一层:Agent 自己建的 wiki,是为某个任务、某个模型、某个 harness 建的,会随它们一起重建或消失。会话是易逝的,常驻上下文昂贵且易错,wiki 可导航但私有。「长期」这两个字,落在不随任何单个 Agent 生灭的那份上下文上。
所以在我看来,企业要建立长期记忆,得把这事拆成四件,缺一件都不稳:
- 得有唯一的事实基准。日志、原件、操作留痕可回溯,整理时才有裁判,纠错才不会变成另一轮猜测。
- 得有真做了抽象的知识结构。别把文件搬进去就算完,要像 Stainless 那 1.3 万条链接一样,把内容之间的关系建出来,重复的分清谁算数、断掉的补上。
- 得有受控的取用与分发。一旦 wiki 要被很多 Agent 读、常驻上下文要被每次会话加载,上下文就从文件变成了服务:统一入口、AI 检索、授权分发、版本唯一、到期失效,出口还得带得上受众与版本信息。这正是 Baklib 下一个版本在做的 Context Share Layer——上下文的取用与分发层。Anthropic 图里 dreaming 的箭头只在一个 Agent 内部上下流动;放大到组织,这些箭头需要一层共同的底座来承载。
- 得让离线整理带上治理属性。Anthropic 自己就承认,表征会累积错误与幻觉、note 会漂移、在线写笔记会把注意力从主任务拉开。一个会在没人看见时悄悄改知识的机制,在企业里必须同时做到来源透明、动作留痕、可纠正、可关闭。
不是把 AI 做得更聪明,而是做得可关闭、可追溯、可纠正。上下文能被 Agent 安全调用,靠的是基础设施给的约束,模型判断力反而在其次。
四条里没有一条是「把模型换得更强」。这跟我在企业侧反复看到的形态是对得上的:阻力几乎都出现在取用和分发,不在有没有地方放。
回到 Baklib 一直讲的那条价值链:Data → Knowledge → Context → Action,护城河落在 Knowledge、Context 和 Governance。这篇长文对我最大的价值,是把 Context 这一层内部的工程复杂度公开摊开了——上下文远不止塞进 prompt 的那段文本,它要分层、要纠错、要建索引、要控制注入、要治理,是一整套基础设施。Anthropic 让一个 Agent 学会了向后看;企业接下来要做的,是让向后看的结果能被整个组织向前使用。
结语
文章最后一节叫 Thinking backward, looking forward。作者写,dreaming 给 Claude 一个向后看的机会,用算力组织记忆、纠正错误、维护表征,让未来的会话更容易取用。
我把这句话换了个主语读一遍:让一个组织向后理解过的经验,变成所有人和所有 Agent 向前工作时,默认就在手边的上下文。
一个 Agent 做梦,是把自己的经历变成自己的知识。一个组织要建立长期记忆,得让这些知识有来源、有版本、有边界、能被安全地反复取用,还得允许有人在它出错时把它关掉、改回来。这件事我做了十五年,只是过去它叫知识治理;现在模型也撞上了同一堵墙,还顺手给了我们一张画得挺清楚的地图。
附:其余原文图版备查
正文按论点用了 9 张,剩下 6 张按 Figure 顺序放在这里。它们对应的实验偏的是单个模型怎么把记忆写好,与「企业长期记忆」这条主线离得远,但作为原文证据链仍然值得留下。
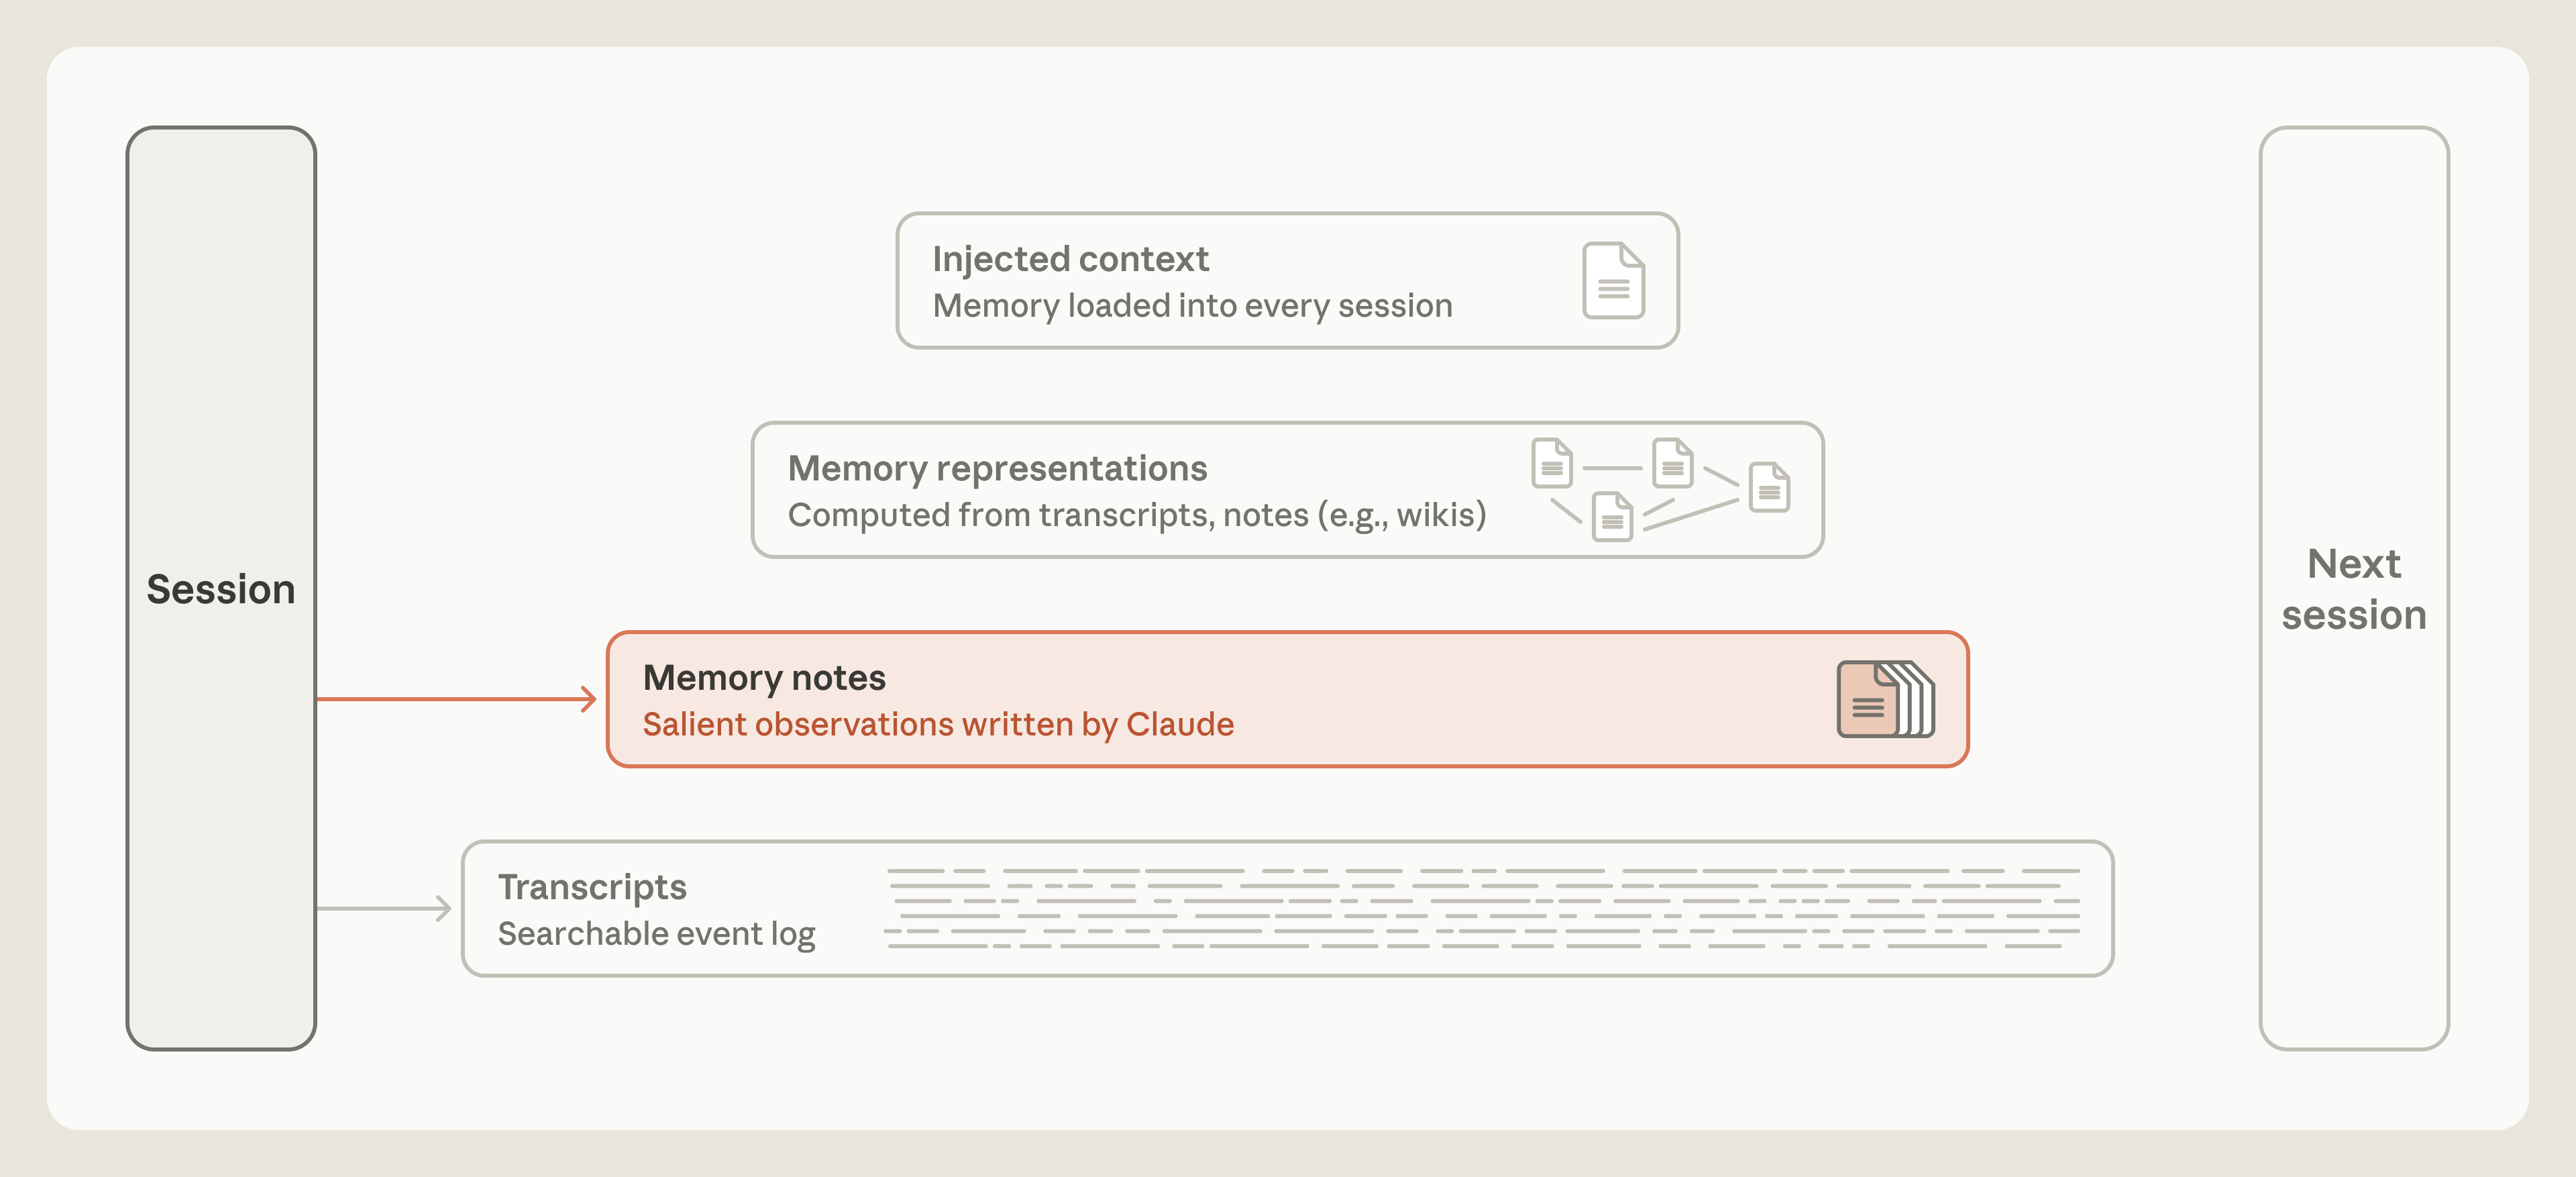
Figure 2|会话直接把「显著观察」写进 memory notes 层。原文 caption:Claude can write notes to memory.
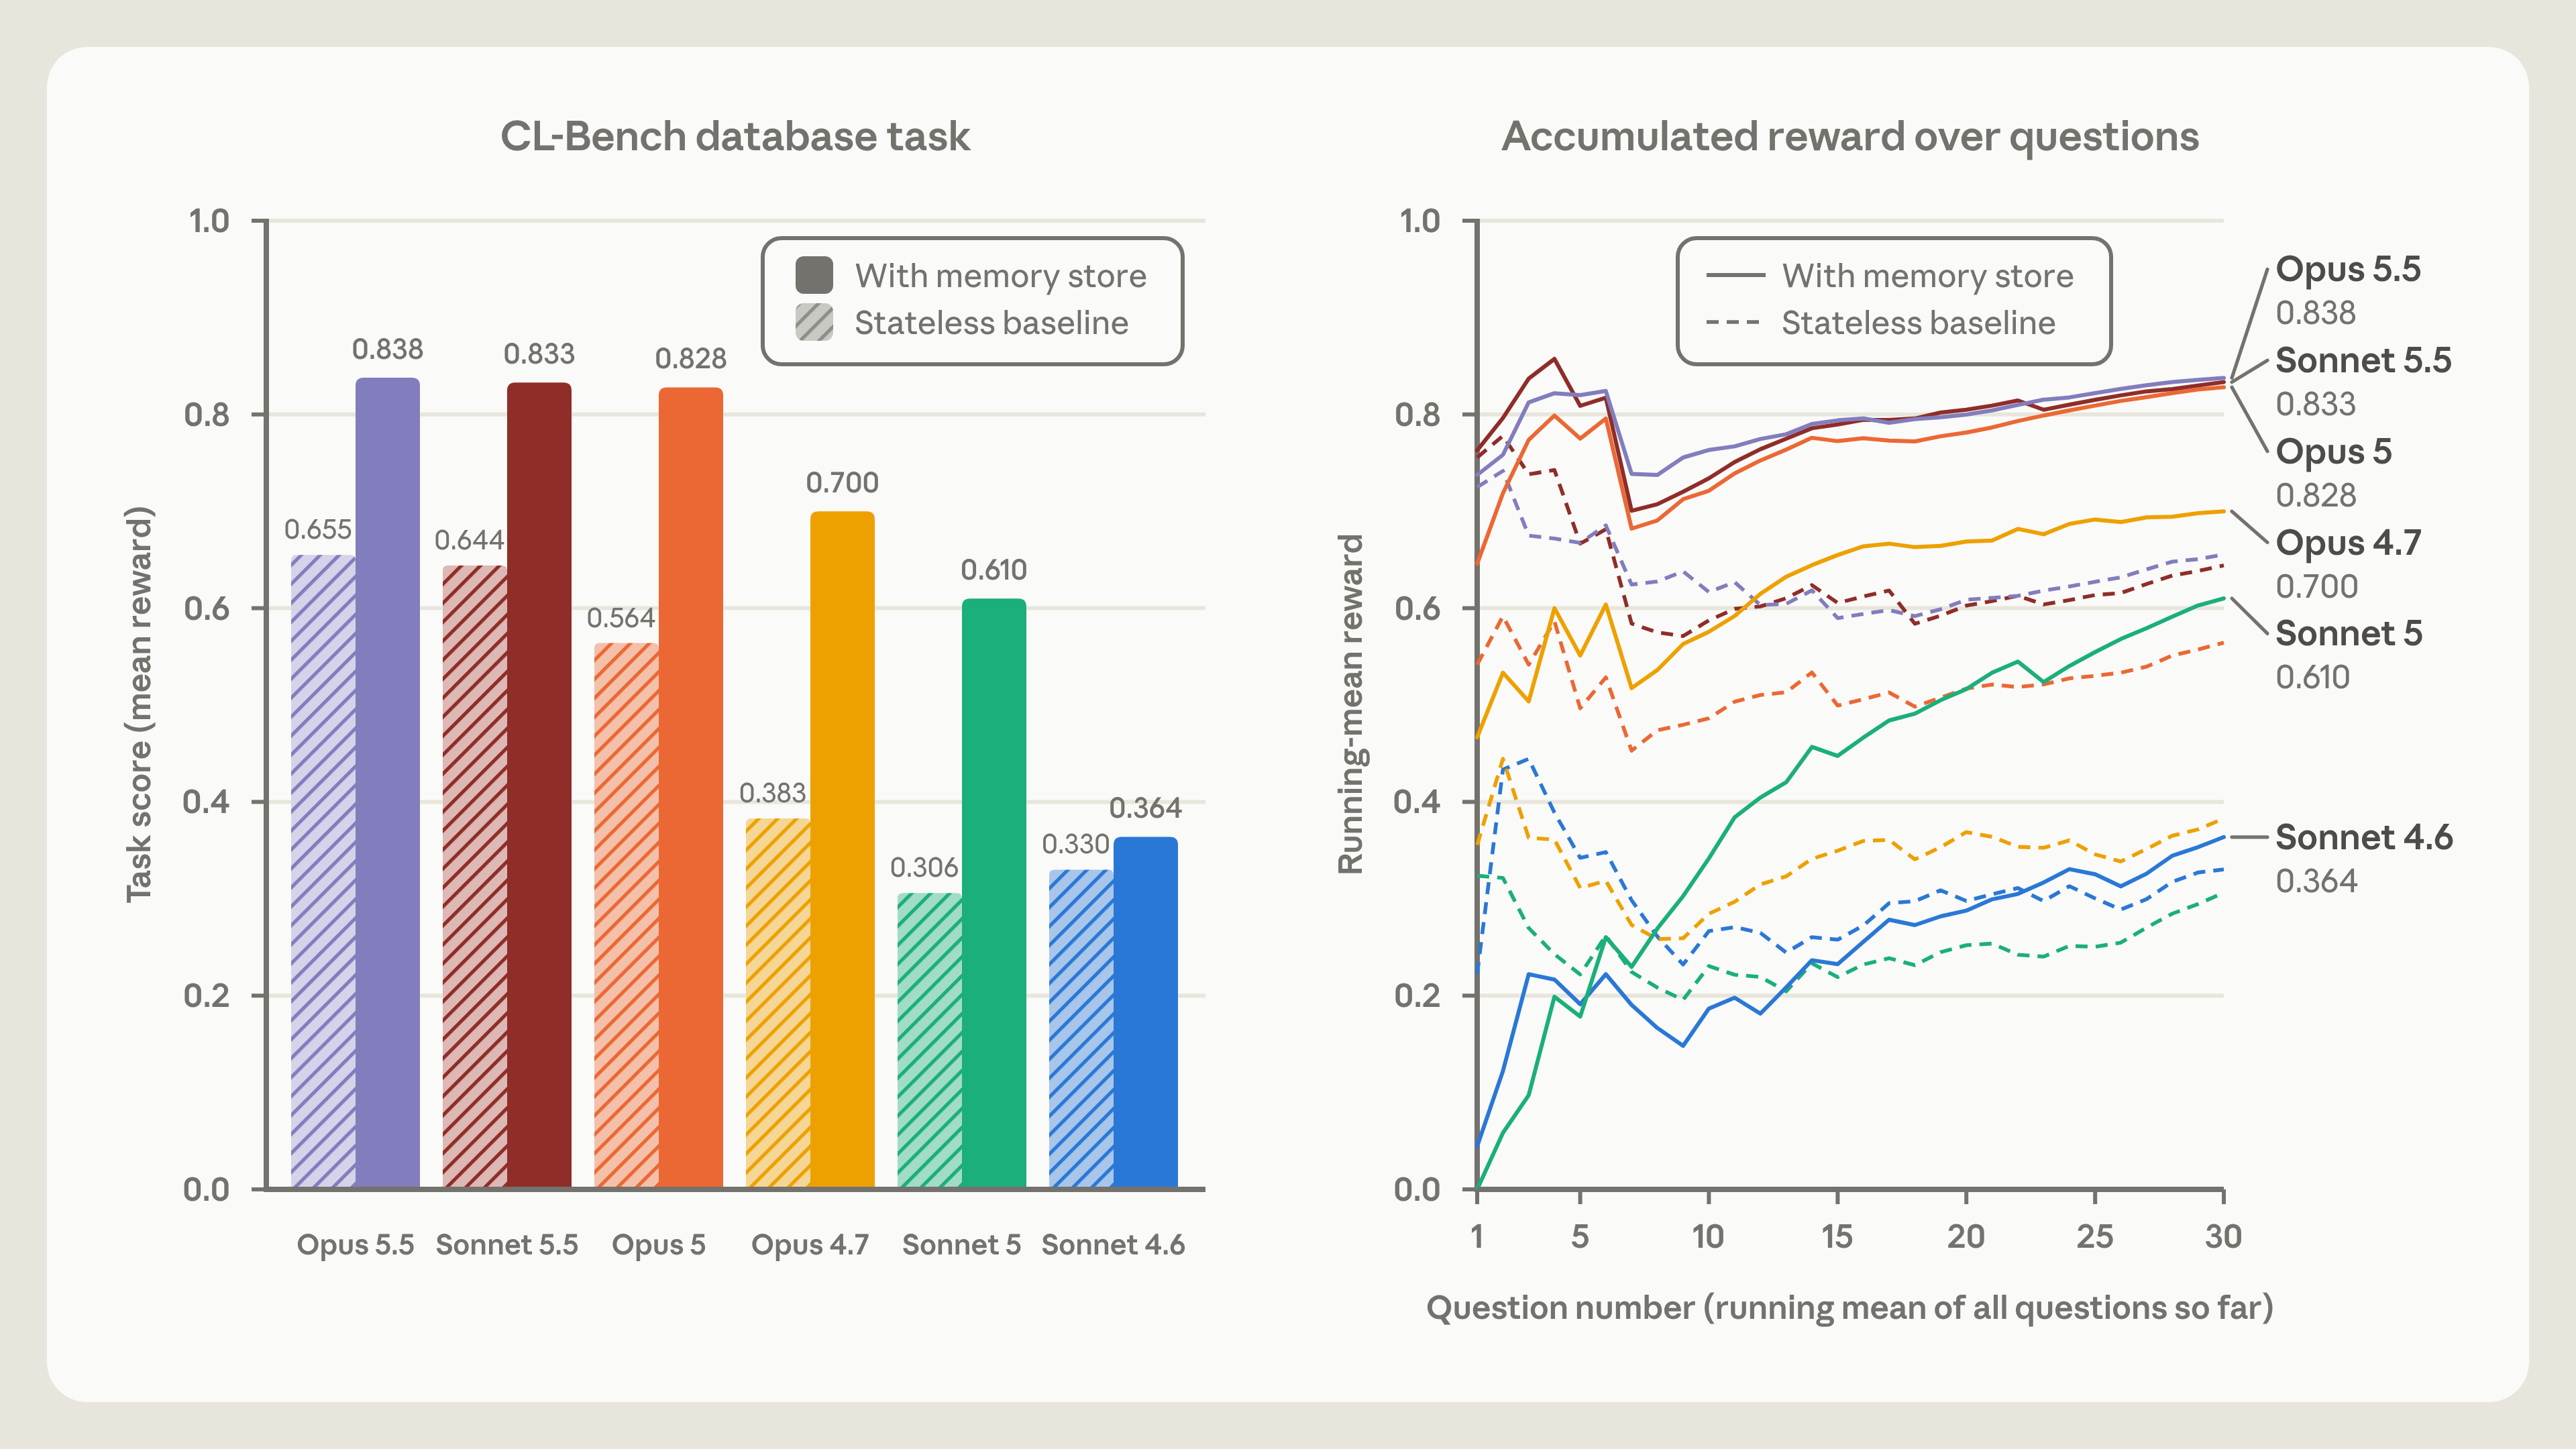
Figure 3|左为柱状图(stateless baseline 对 memory store),右为 30 题上的 running-mean 曲线。原文 caption:CL-Bench database task, comparing memory with a stateless baseline across models.
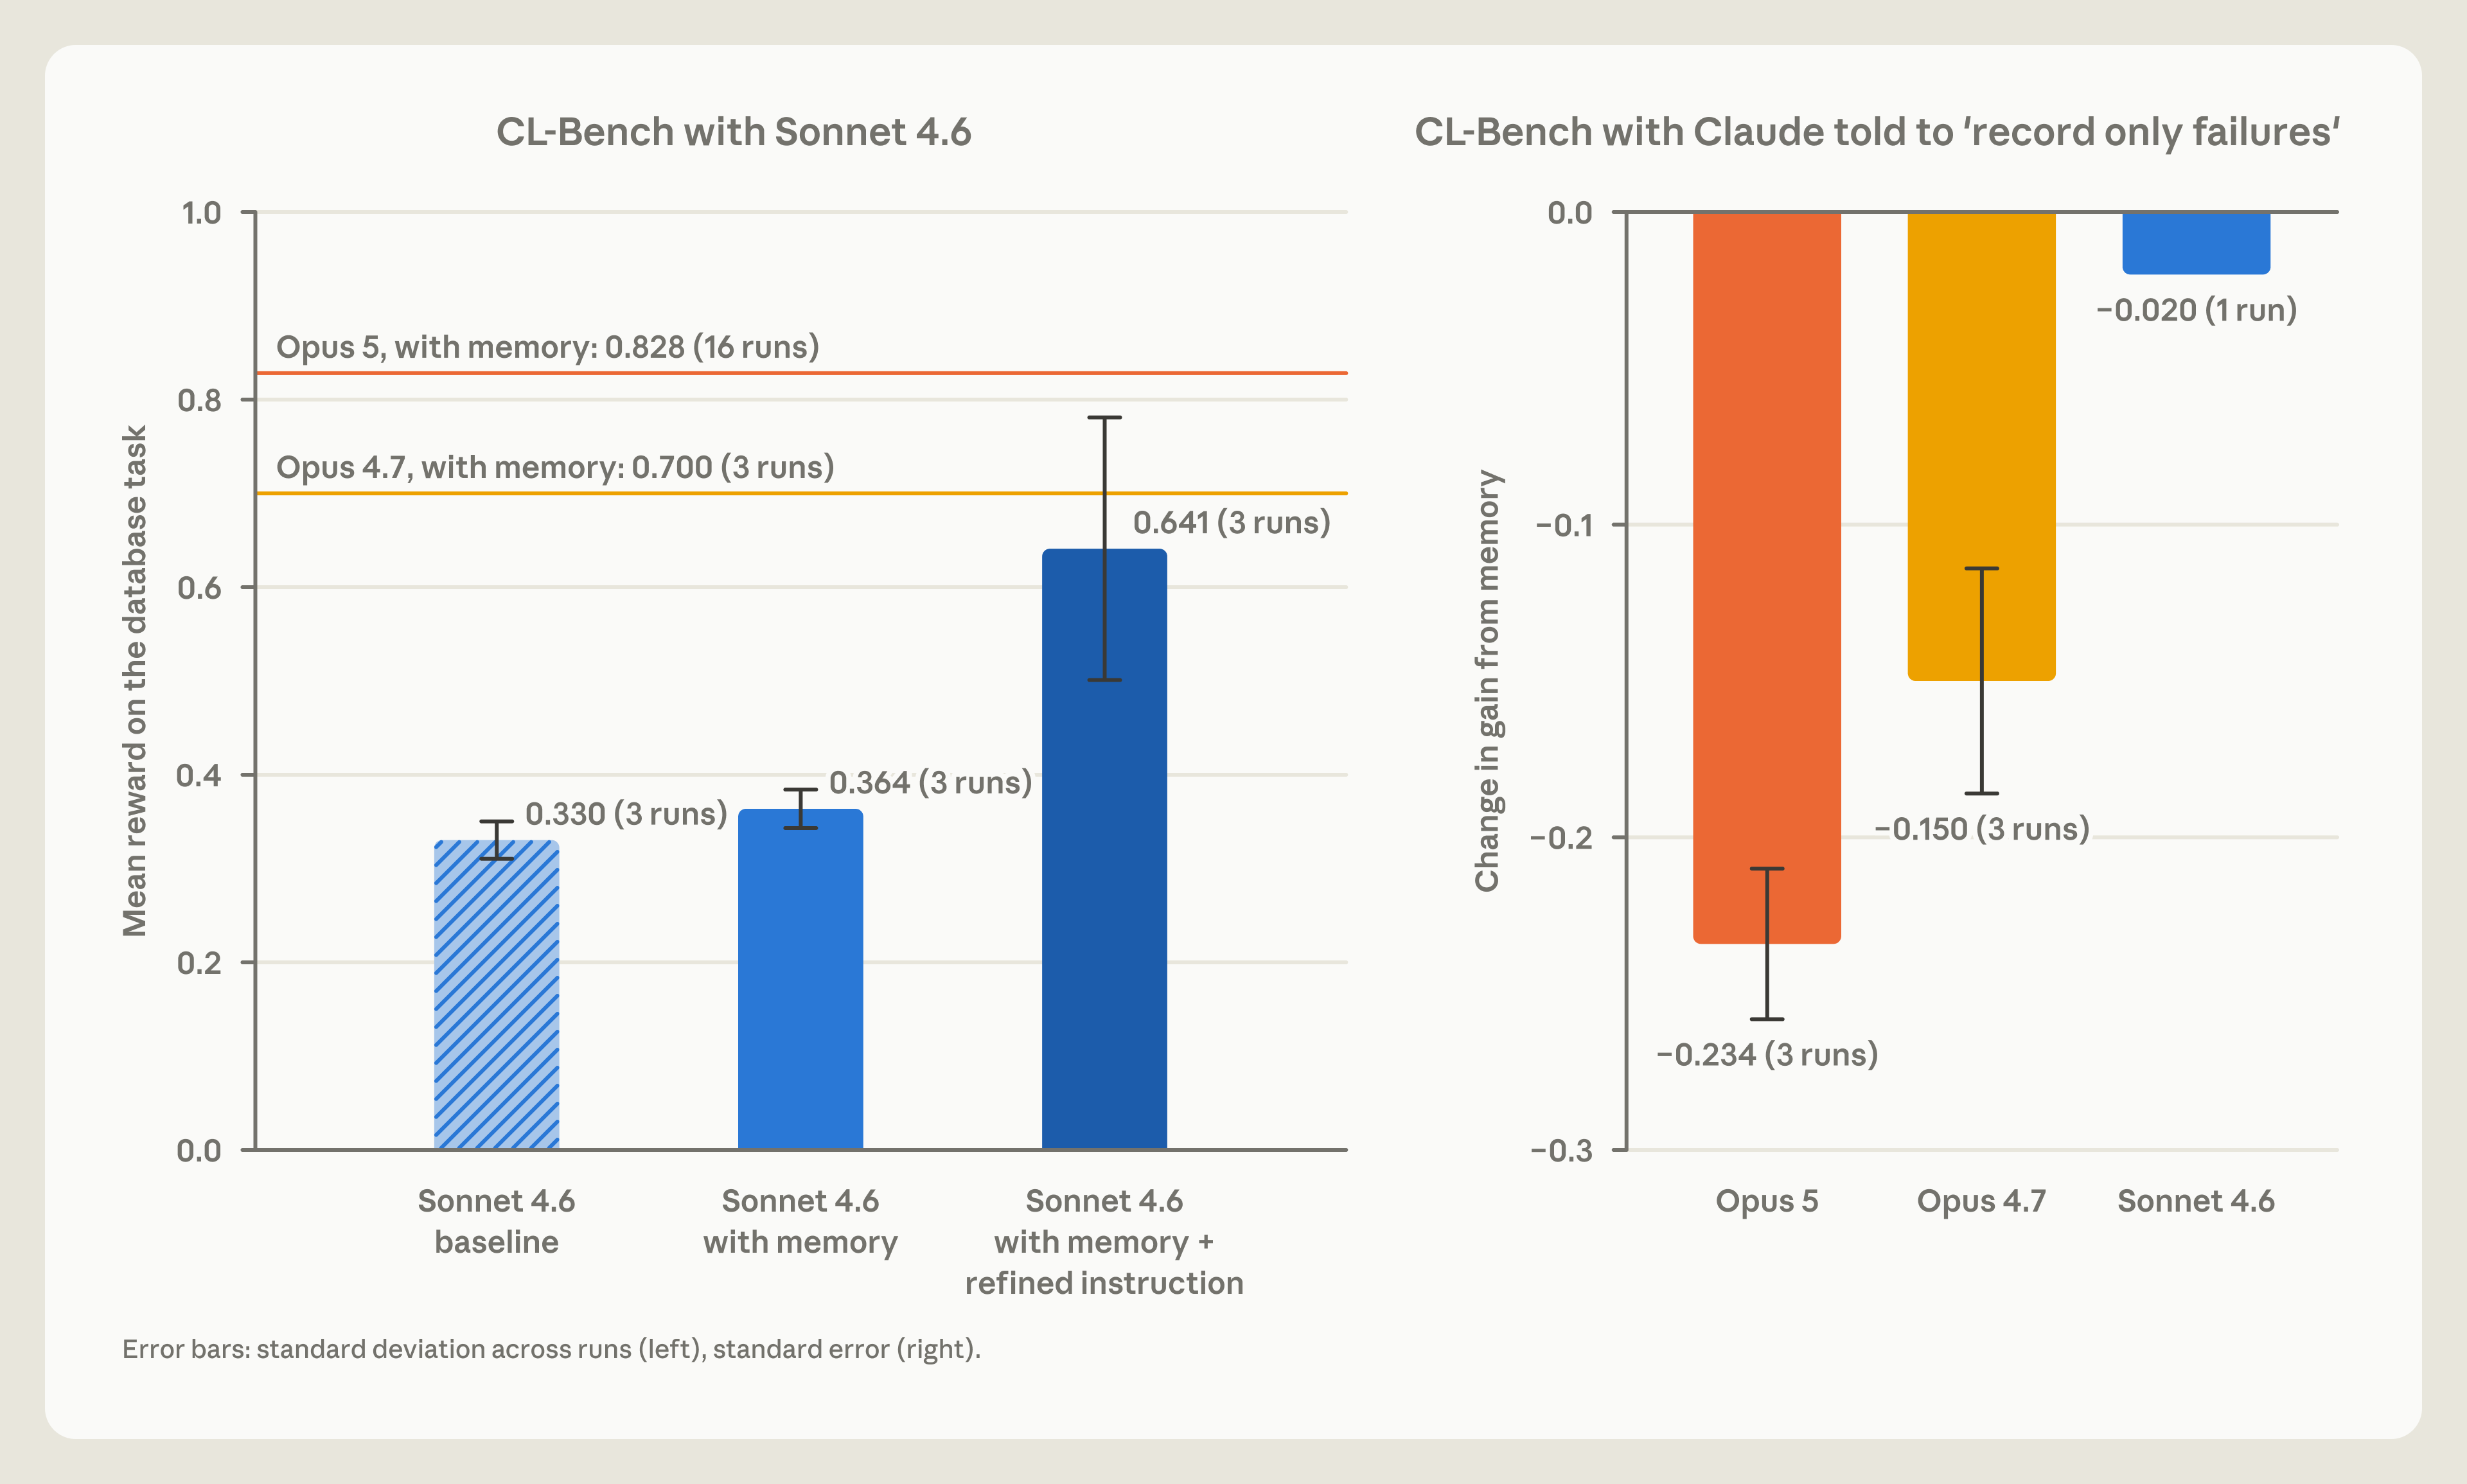
Figure 5|左:给旧模型补一句引导,Sonnet 4.6 从 0.364 抬到 0.641;右:硬规则「只记录失败」让 Opus 5 的记忆增益掉 0.234。原文 caption:Left: Sonnet 4.6 on the CL-Bench database task with and without prompting to guide memory usage. Right: how much each model’s gain from memory changed when it was told to record only failures.
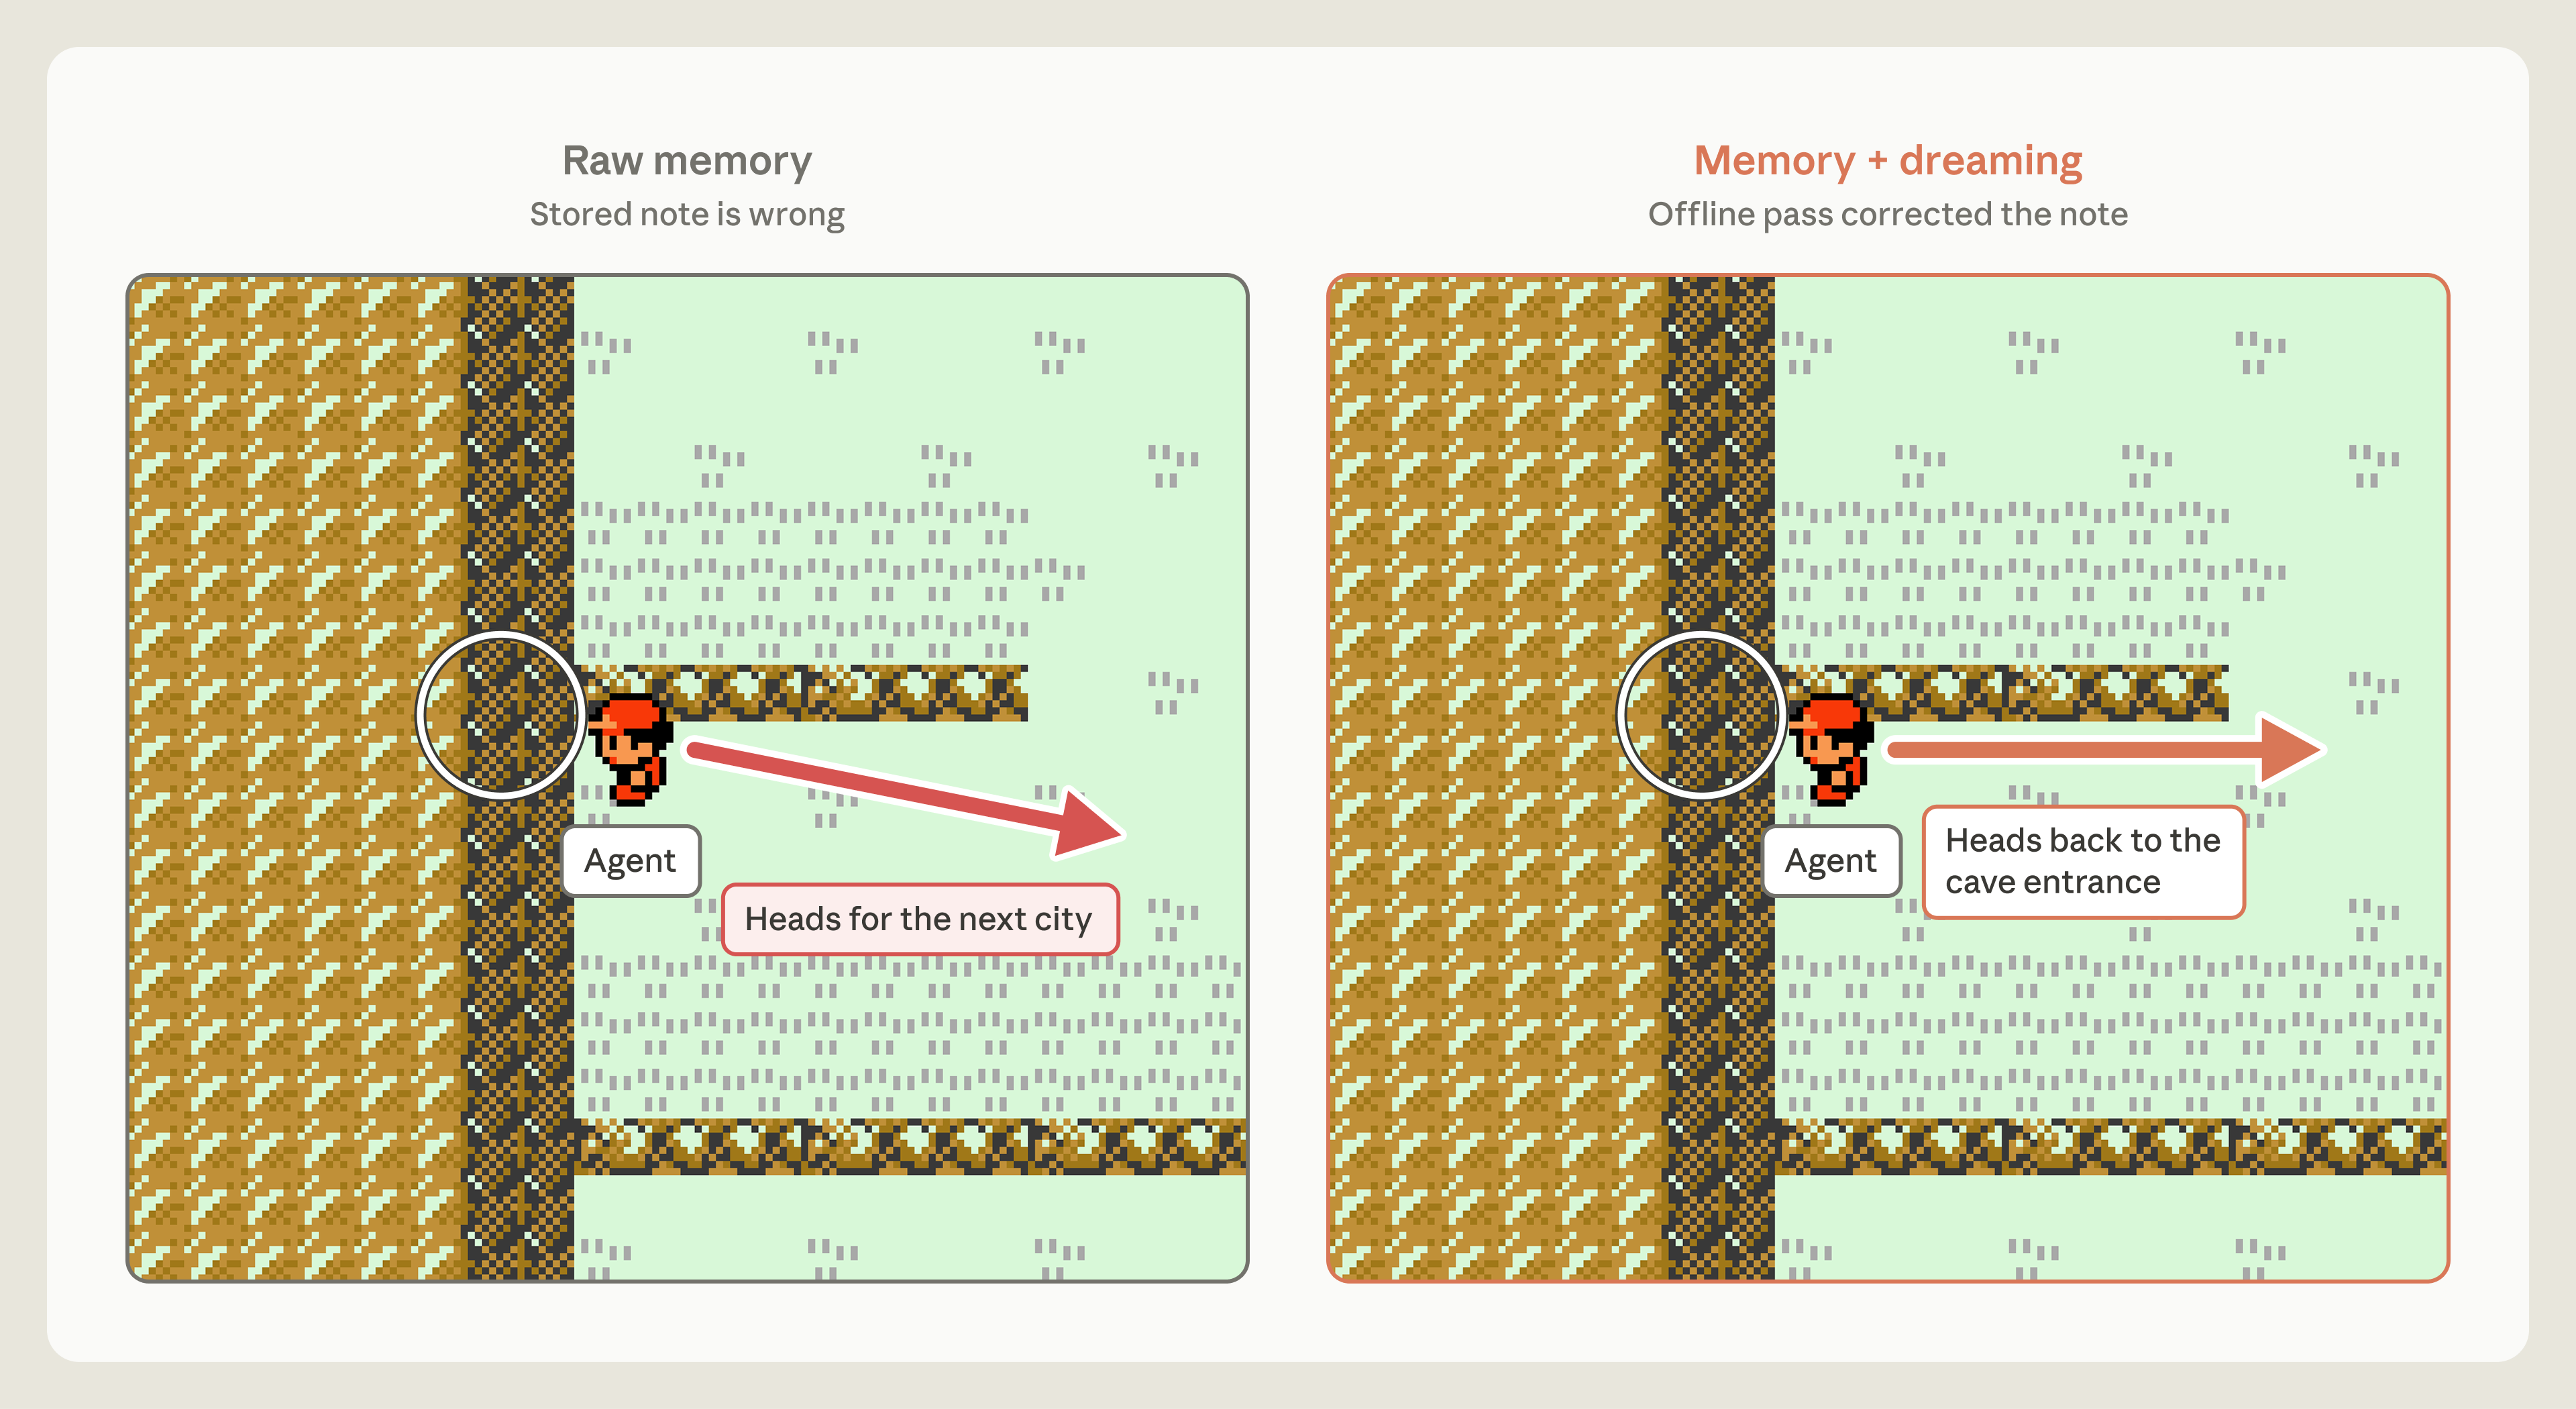
Figure 7|左为 Raw memory,箭头朝下一座城市;右为 Memory + dreaming,箭头折回洞口。原文 caption:A corrected memory note changed the outcome in Pokémon.
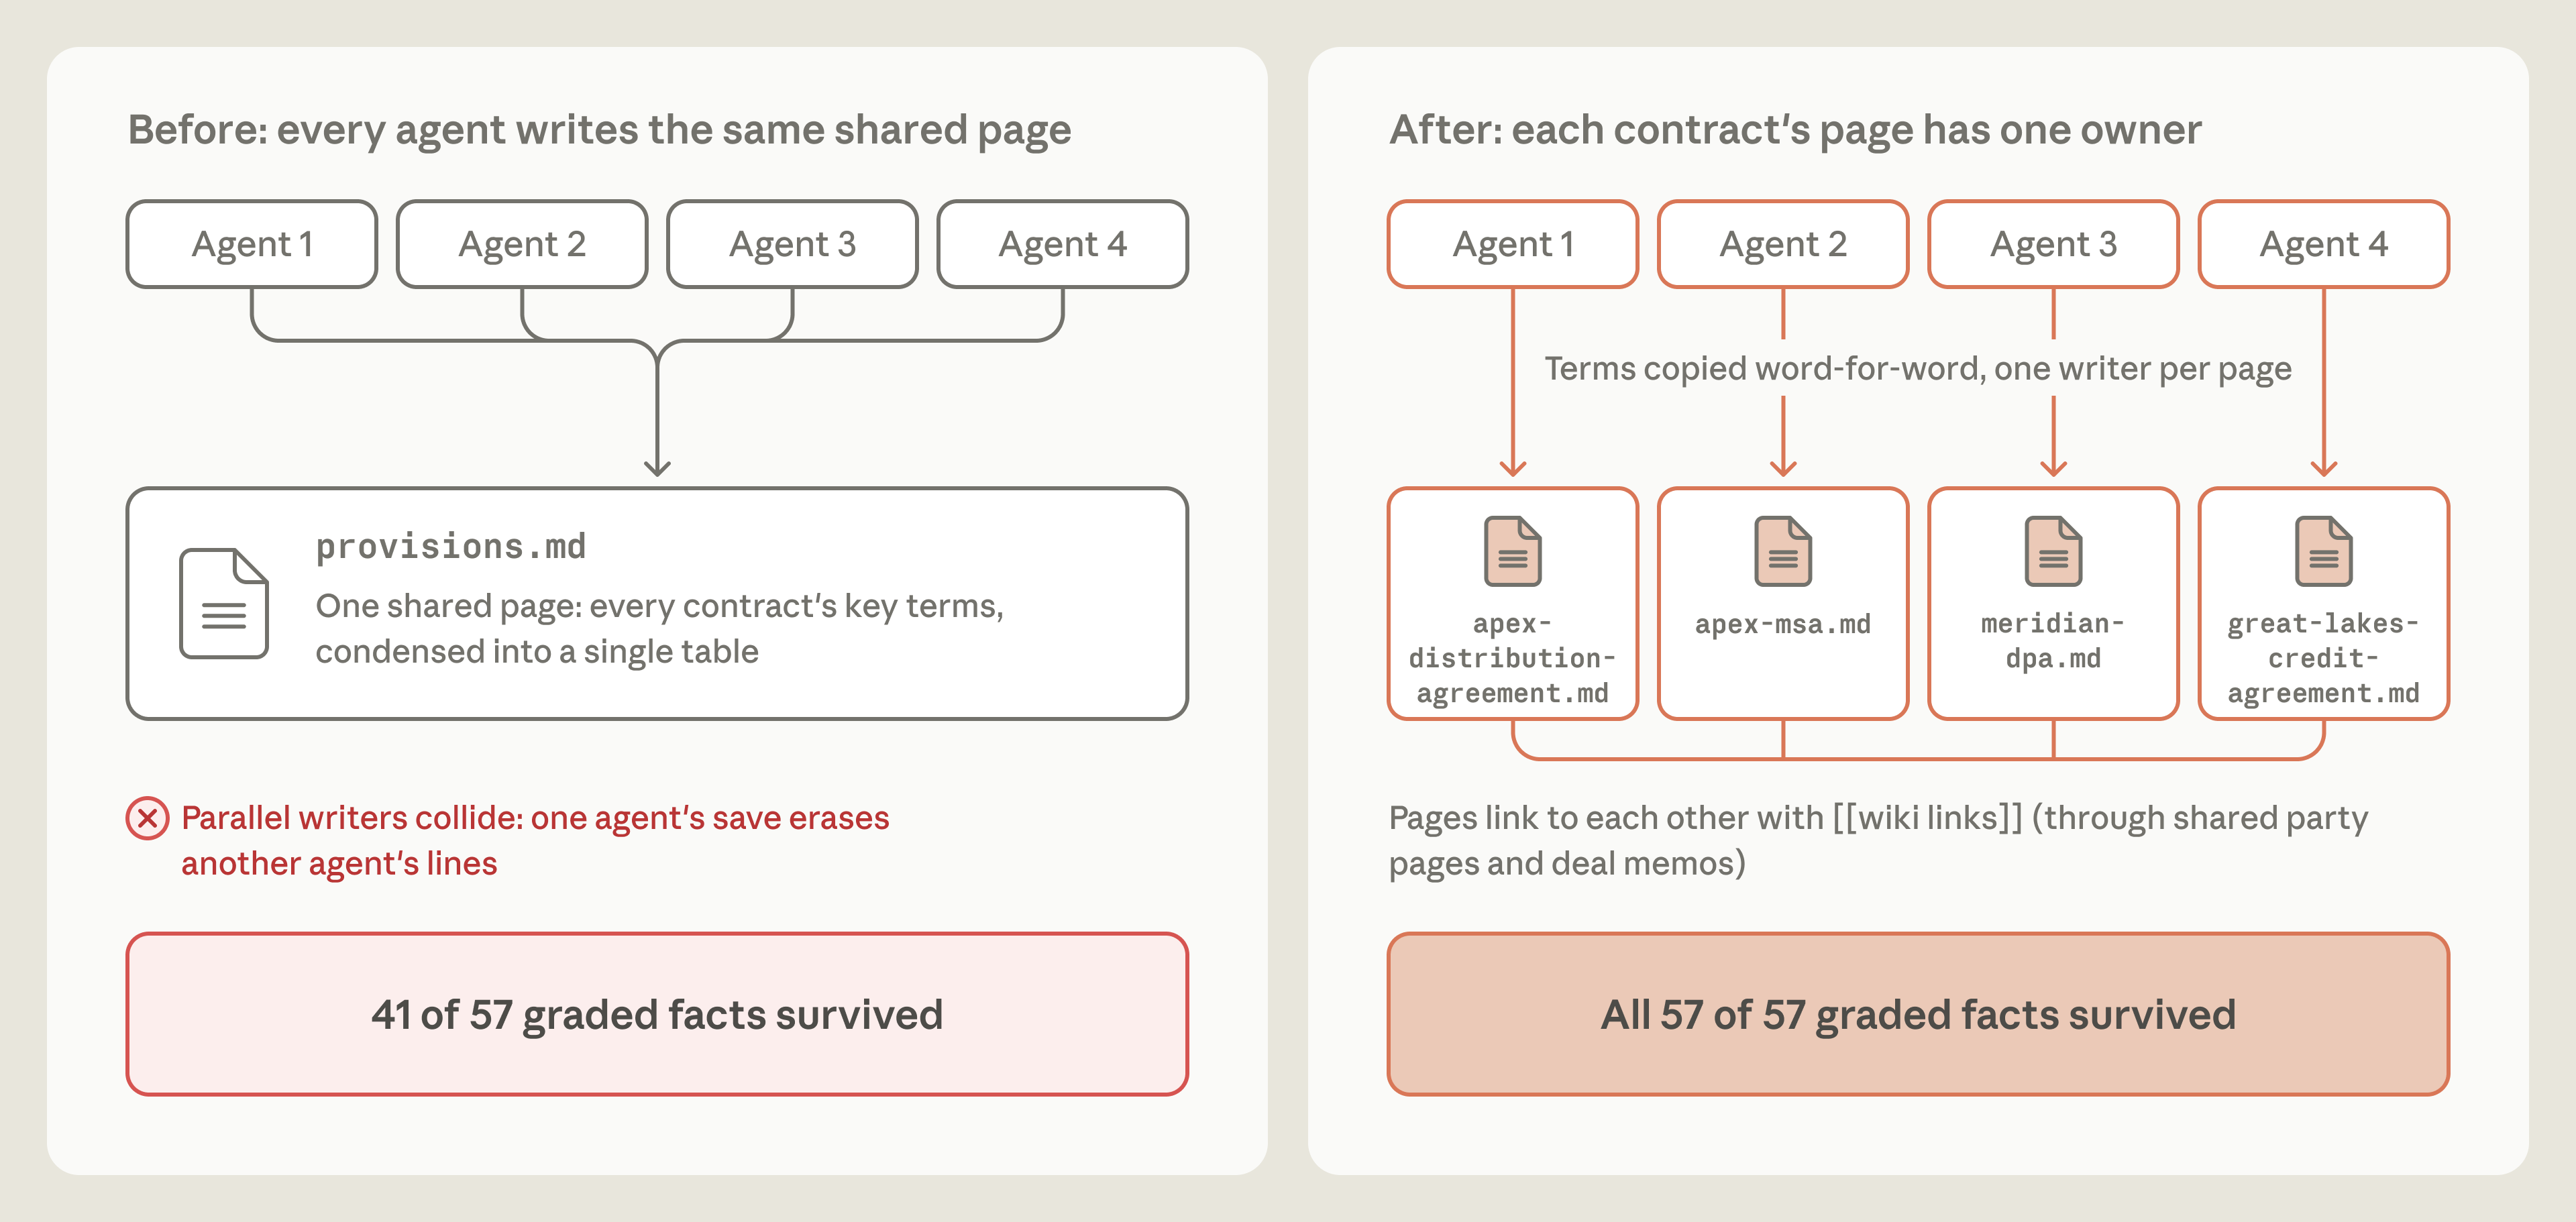
Figure 14|四个 agent 共写一页时 57 条事实只活下来 41 条;改成一份合同一页、逐字引用条款后 57 条全在。原文 caption:How many graded contract facts made it into the wiki, before and after instructions changed.
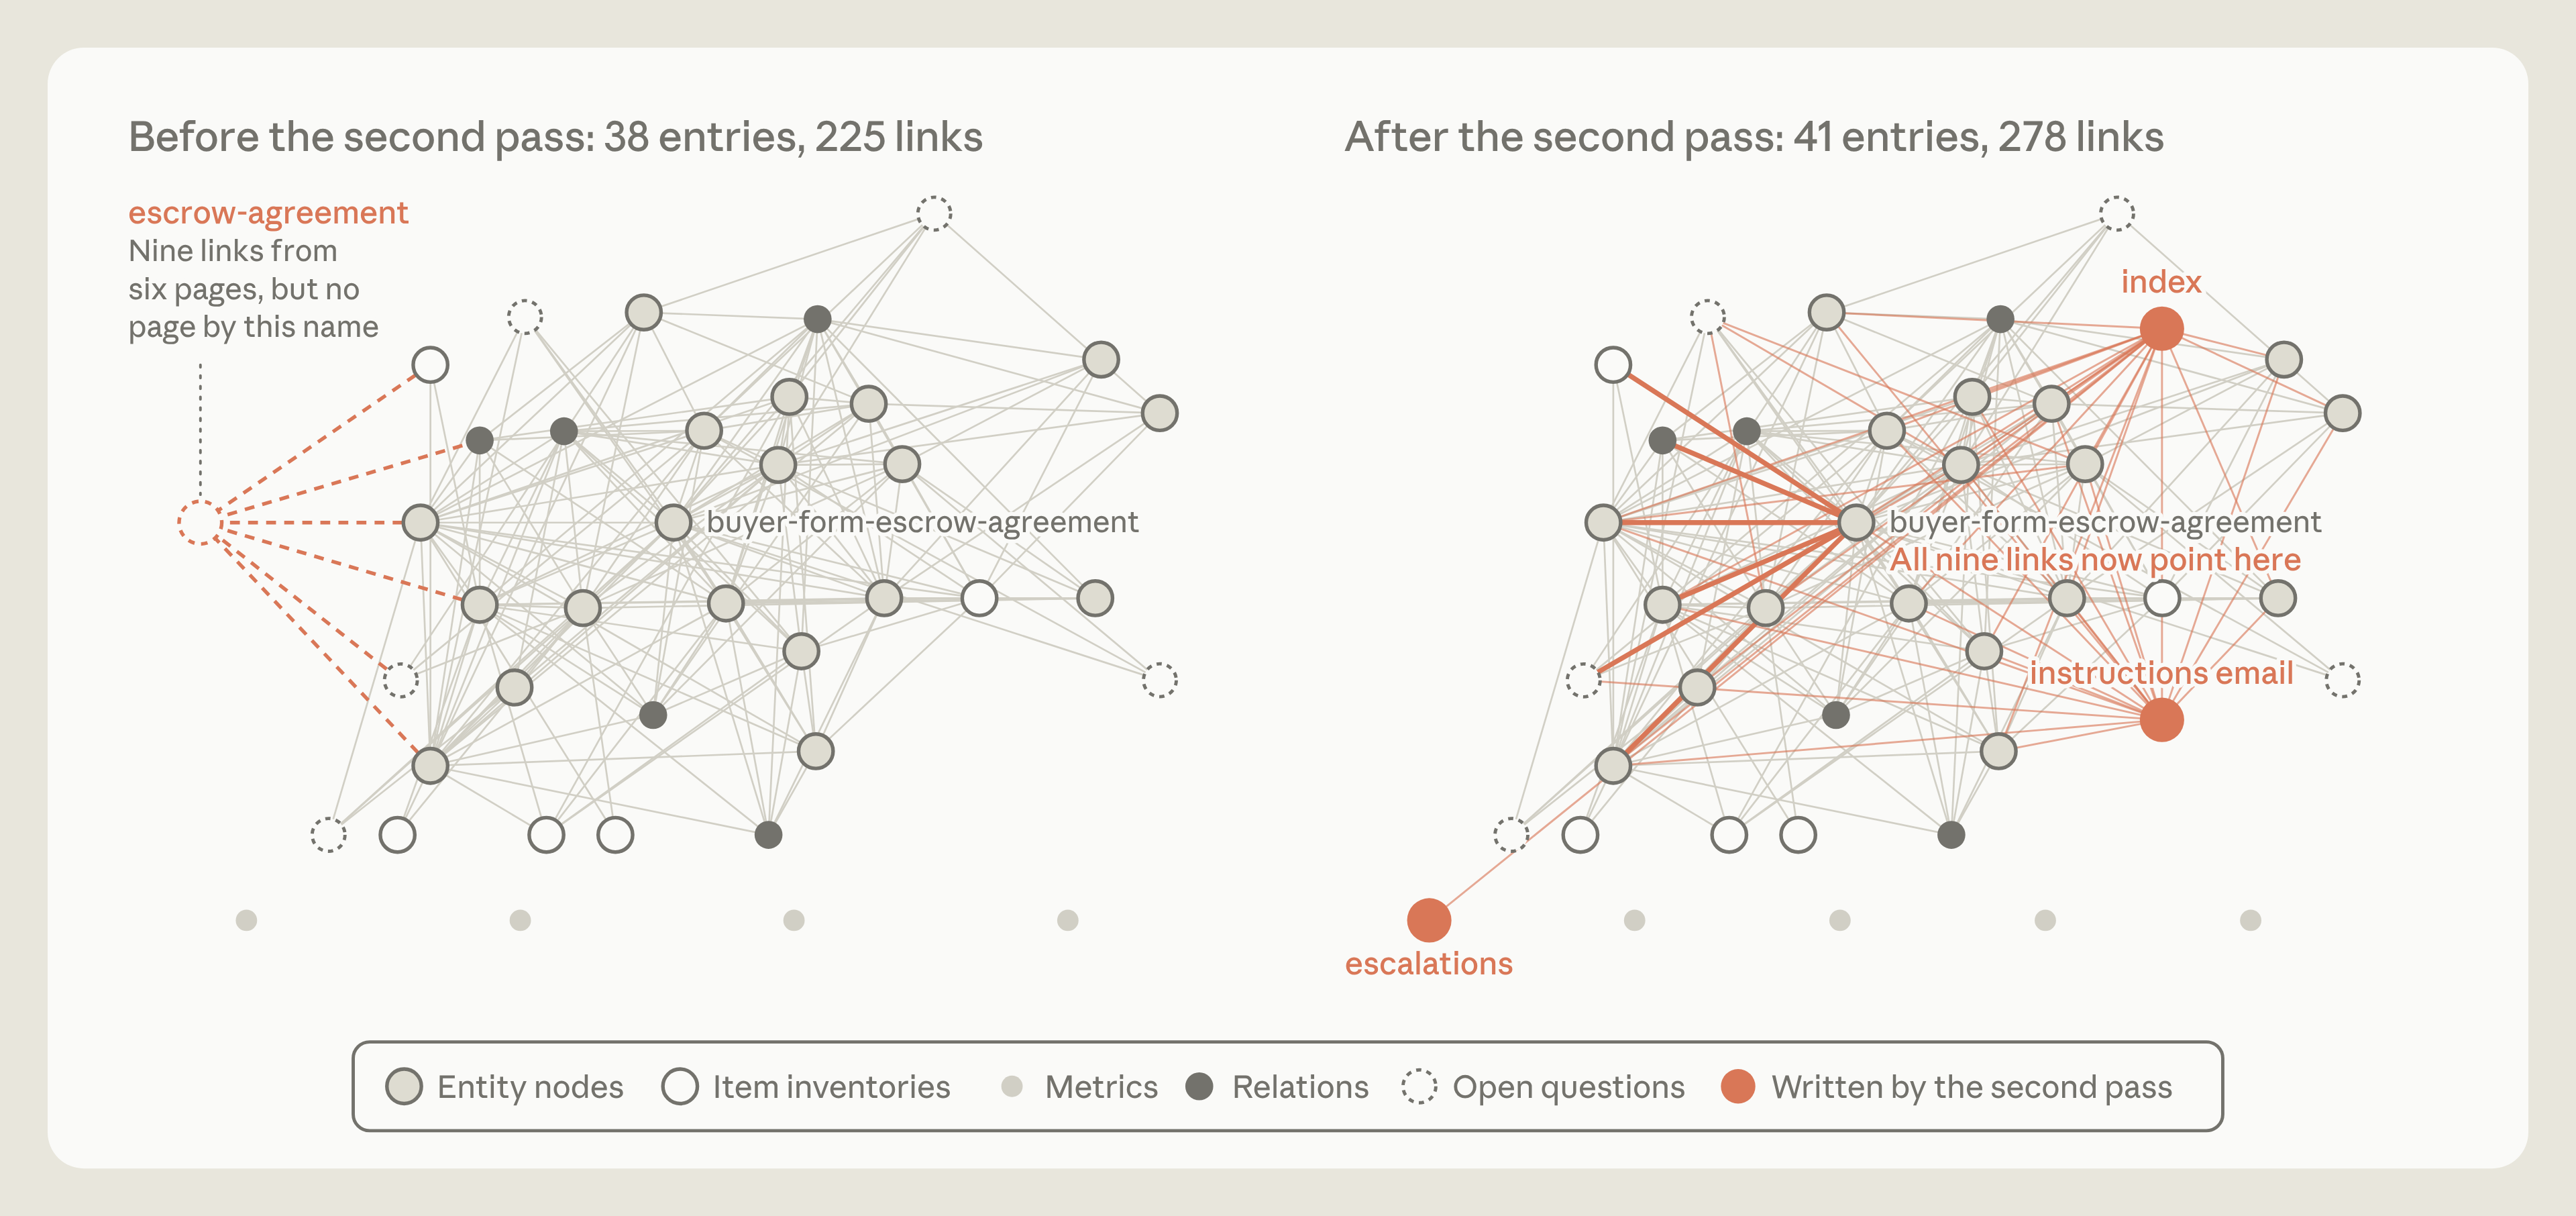
Figure 15|9 条指向不存在页面的链接被重指向已有页面,并新增 3 个页;38 条 / 225 链接变成 41 条 / 278 链接。这张图对应本文第四节里「断掉的补上」那一条。原文 caption:The wiki before and after a second dreaming pass.
参考原文:The components of agent memory,Anthropic Engineering,2026 年 11 月 6 日,Lance Martin 撰写,Monika Tuchowska 配图。文中所有事实、引文与数据均出自该文,未引入其他资料。本文所用 15 张图即原文 Figure 1–15 的原图,仅作研究评论引用,版权归 Anthropic 及原作者所有。原文链接:https://www.anthropic.com/research/components-of-agent-memory
Baklib · Context 系列
想要了解更多?

数字内容新基建白皮书

